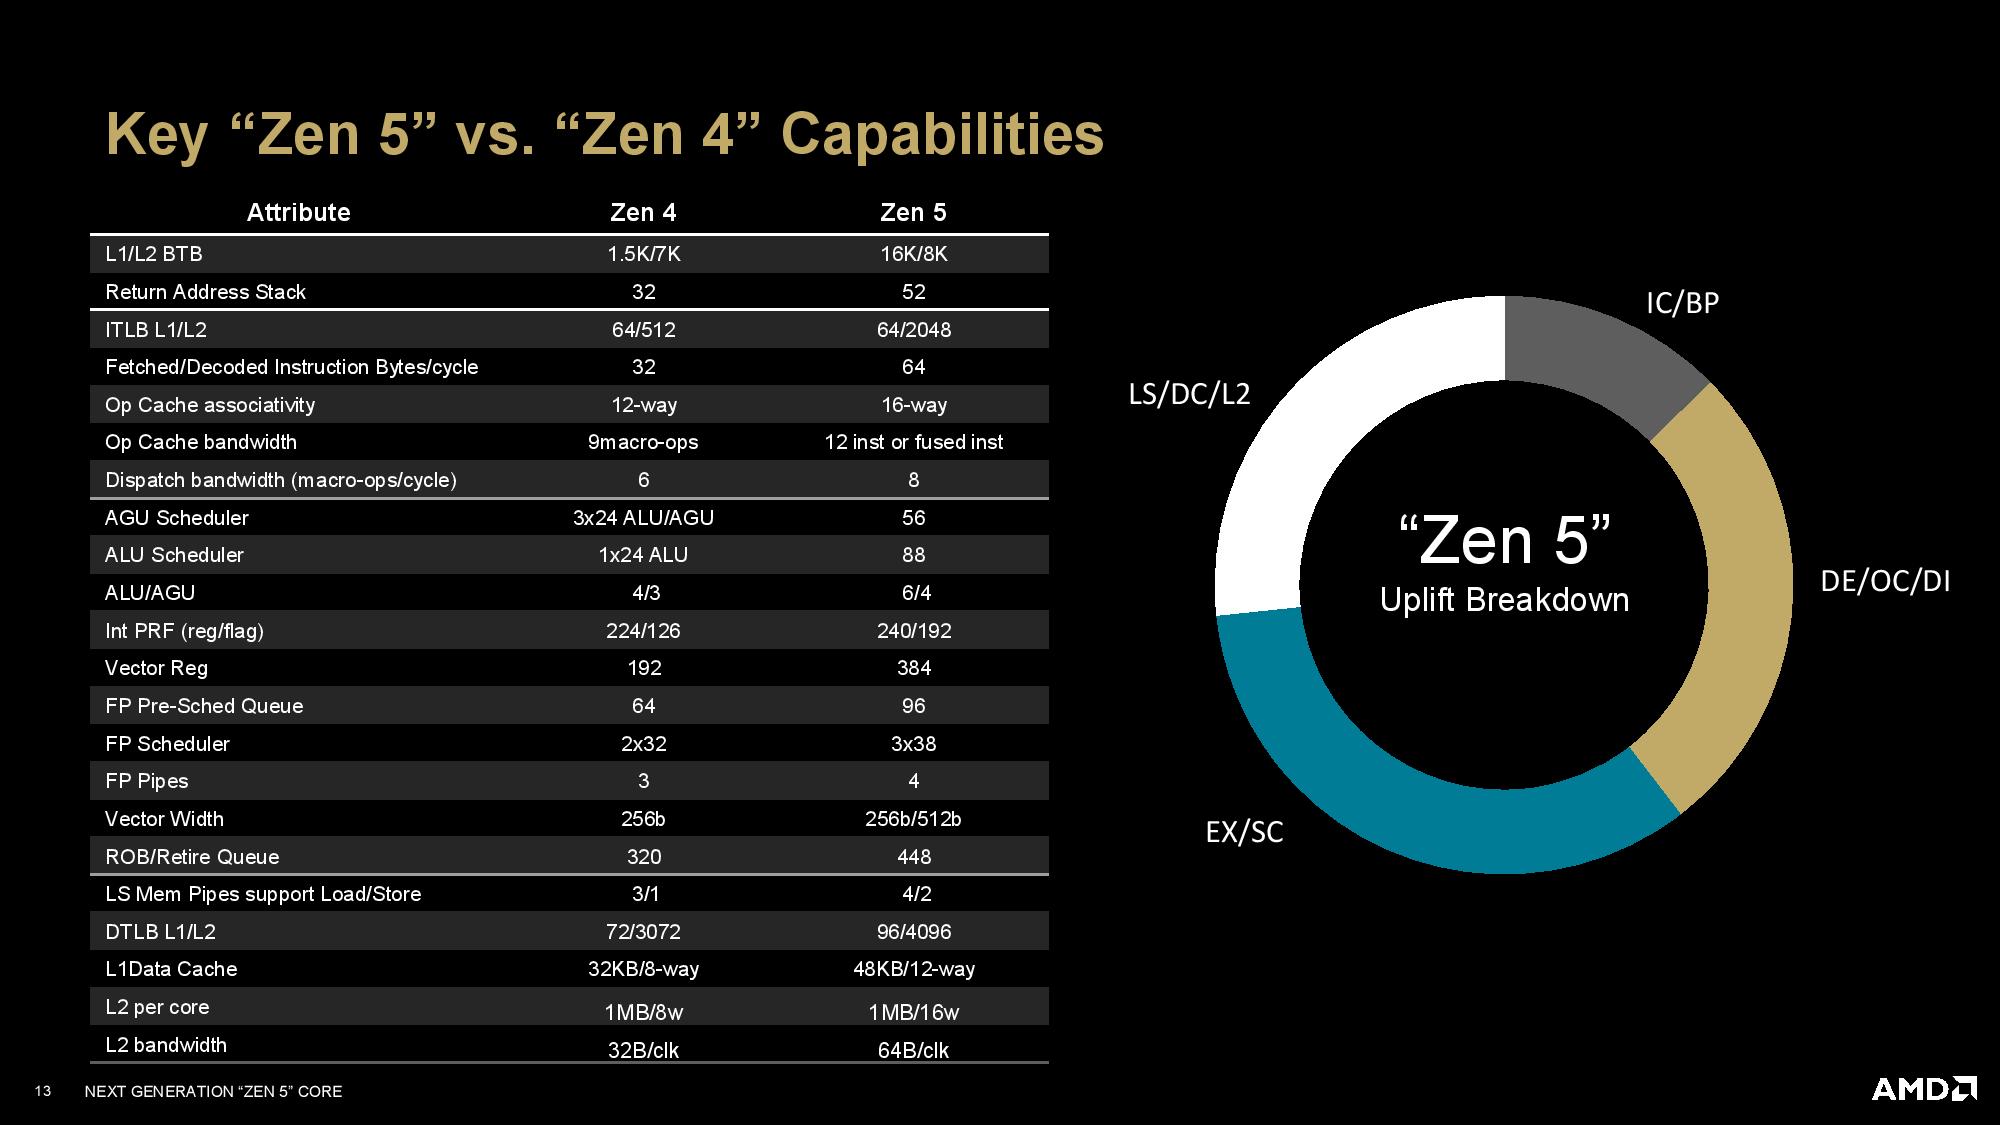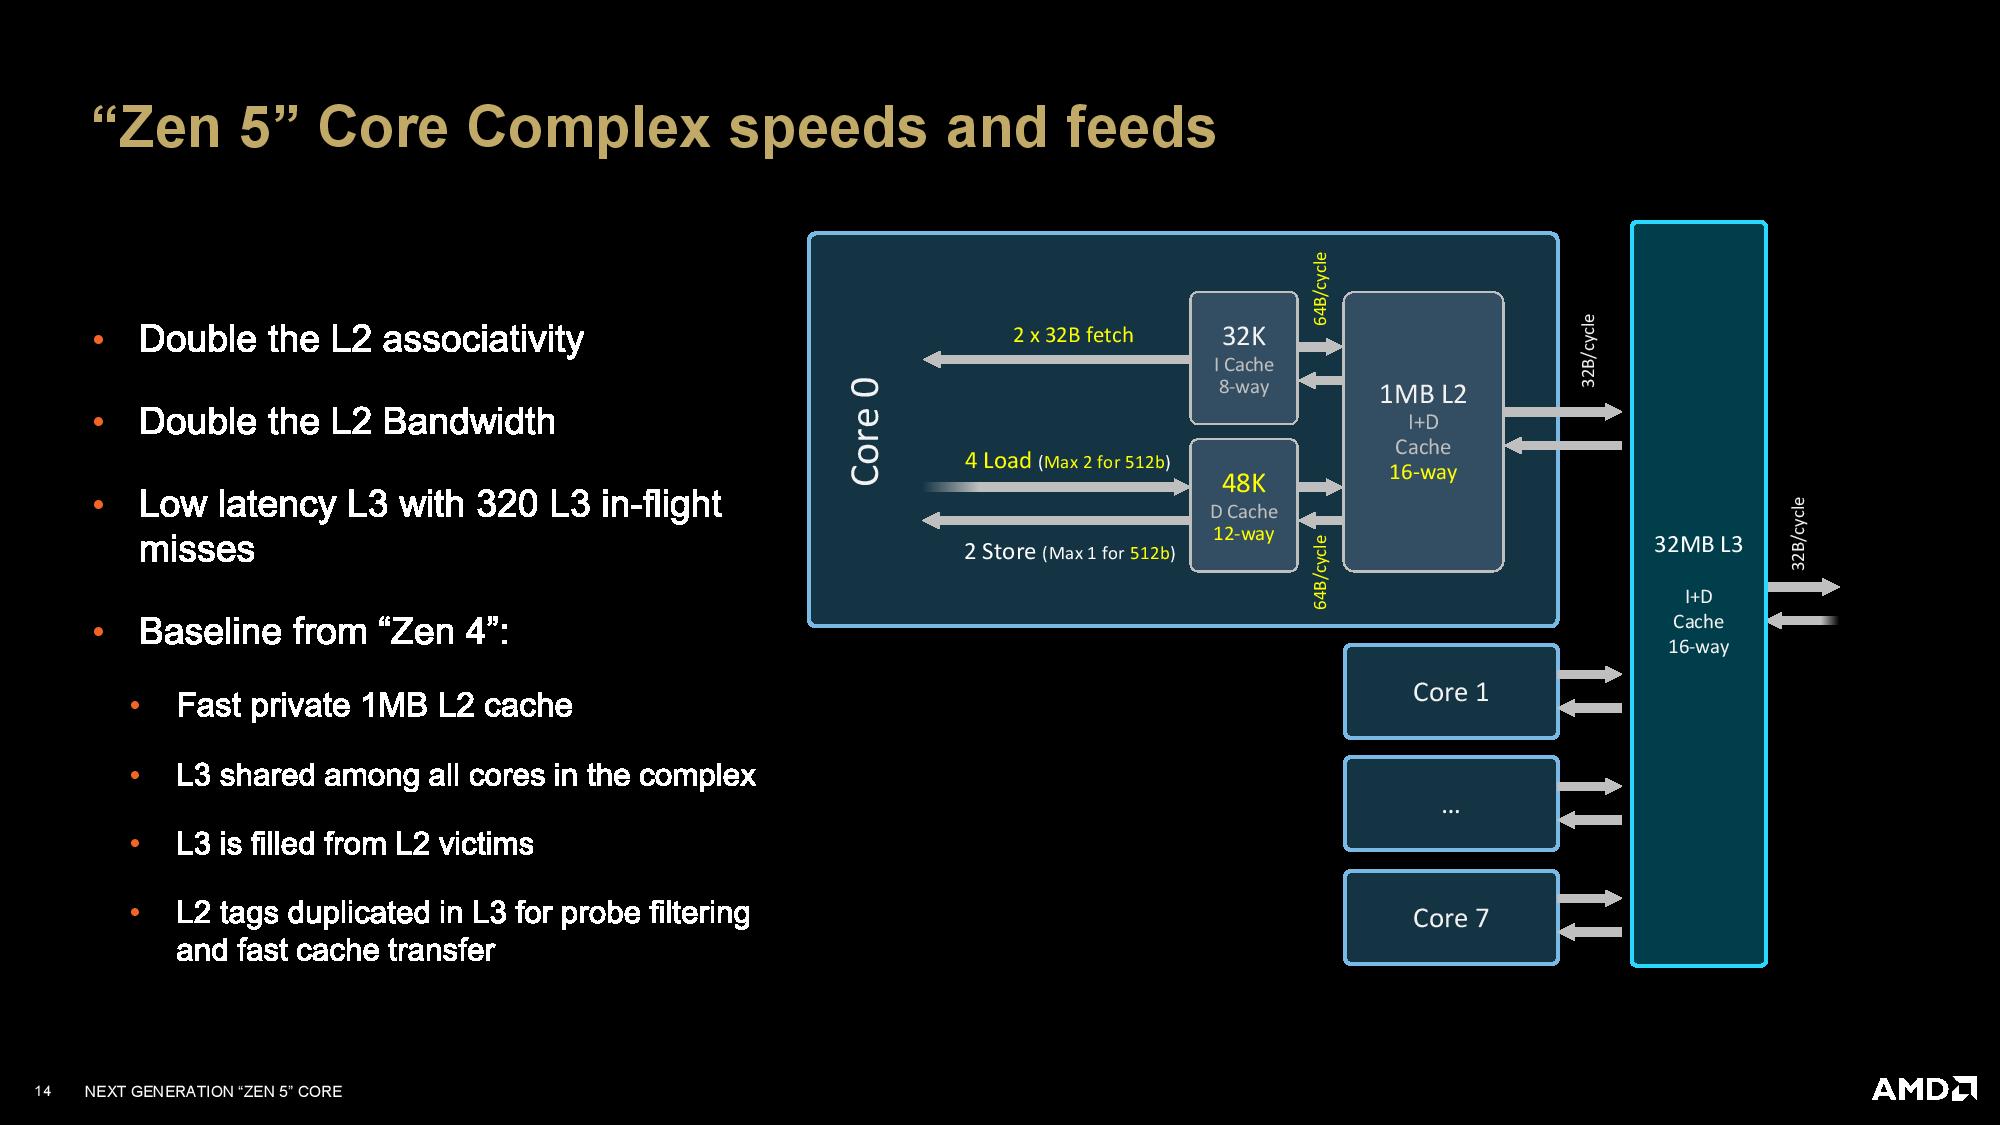


AMD realizou recentemente o seu Zen 5 Tech Day, revelando os detalhes dos próximos processadores Ryzen 9000 ‘Granite Ridge’ e Ryzen AI 300 ‘Strix Point’. No entanto, a empresa seguiu esta semana com mais detalhes sobre a microarquitetura Zen 5 e o layout do SoC.
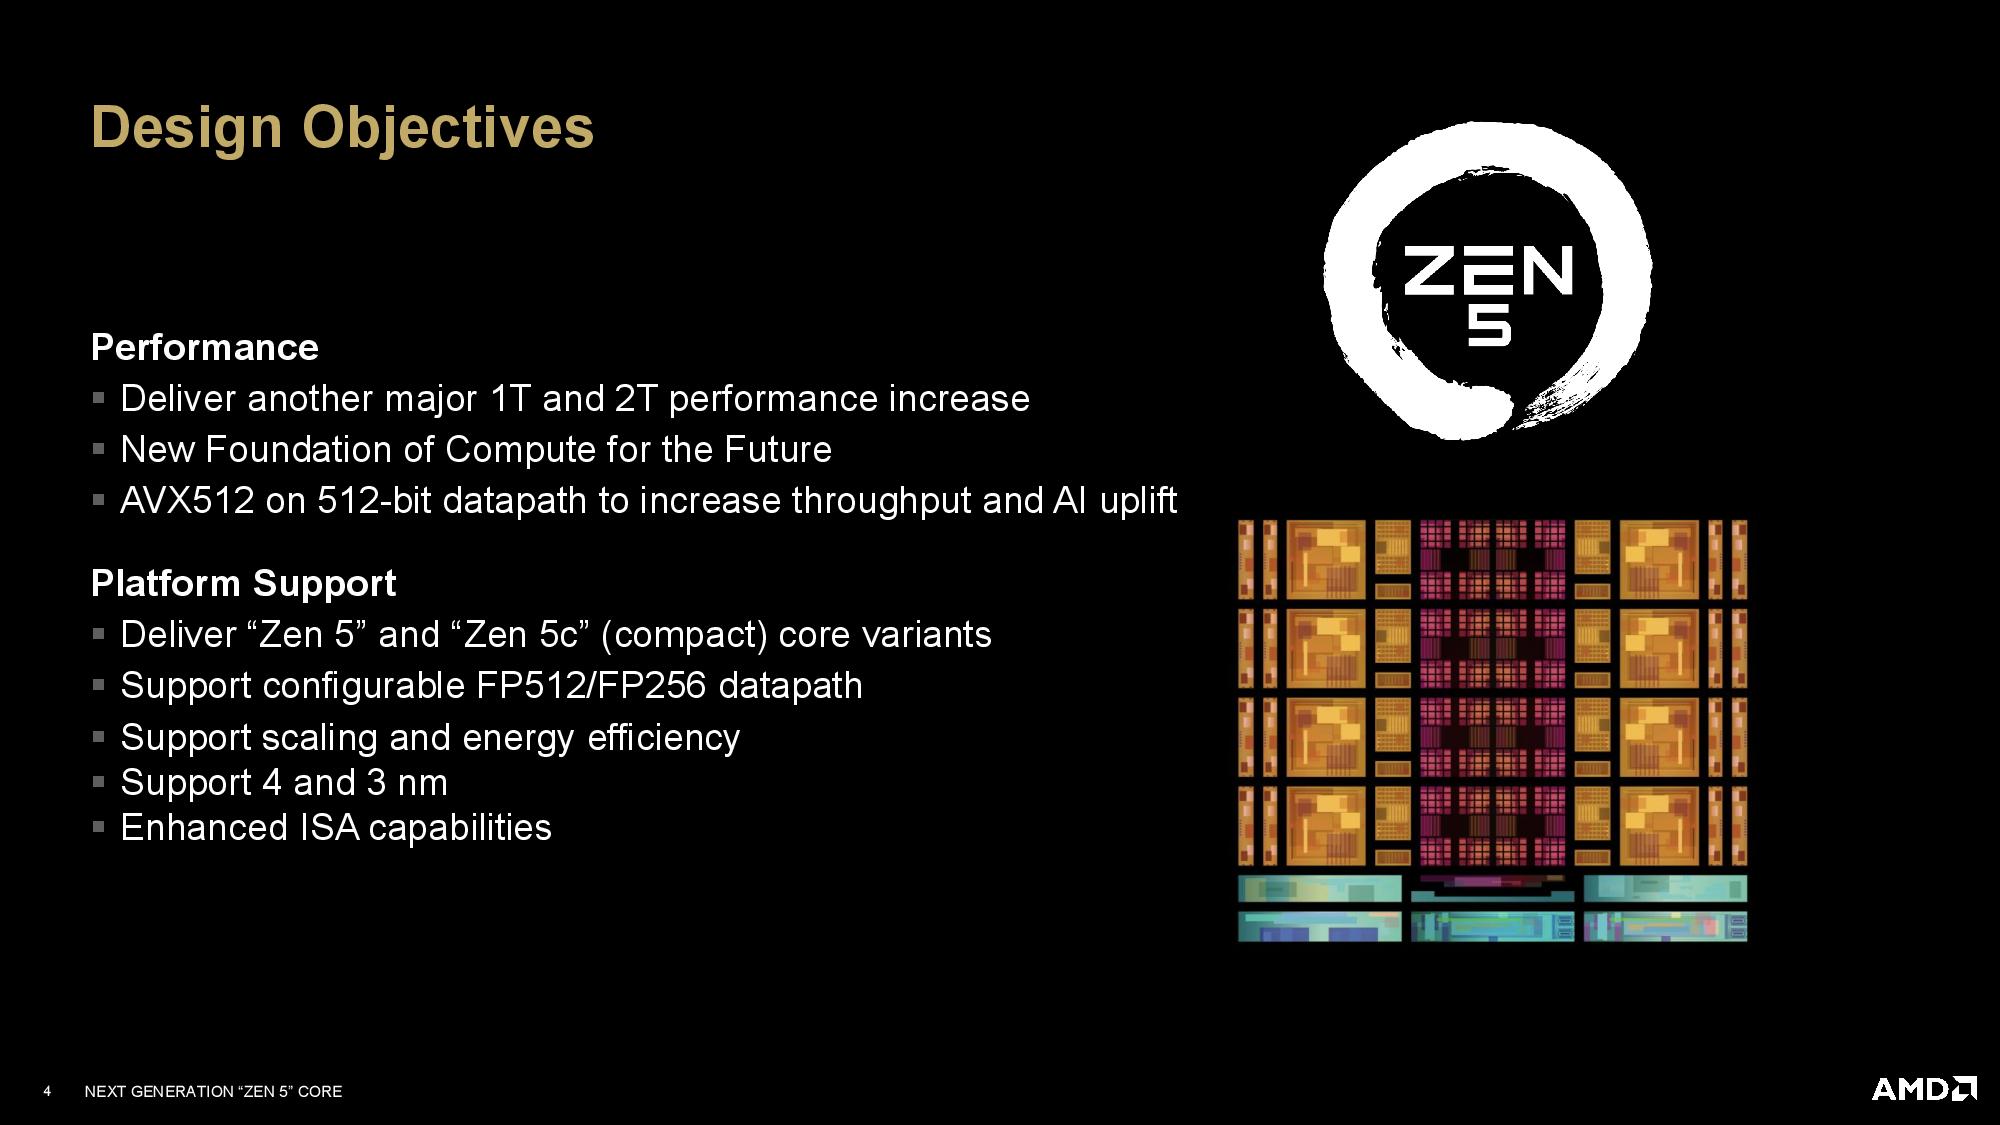
A AMD revelou que os núcleos ‘compactos’ Zen 5c são aproximadamente 25% menores que os núcleos Zen 5 padrão e que os dois tipos de núcleos têm diferentes quantidades de cache no mesmo chip — uma novidade em um design da AMD. A empresa também anunciou outros detalhes técnicos interessantes, que abordaremos abaixo.
Os SoCs e a redução de ~25% na área do Zen 5c
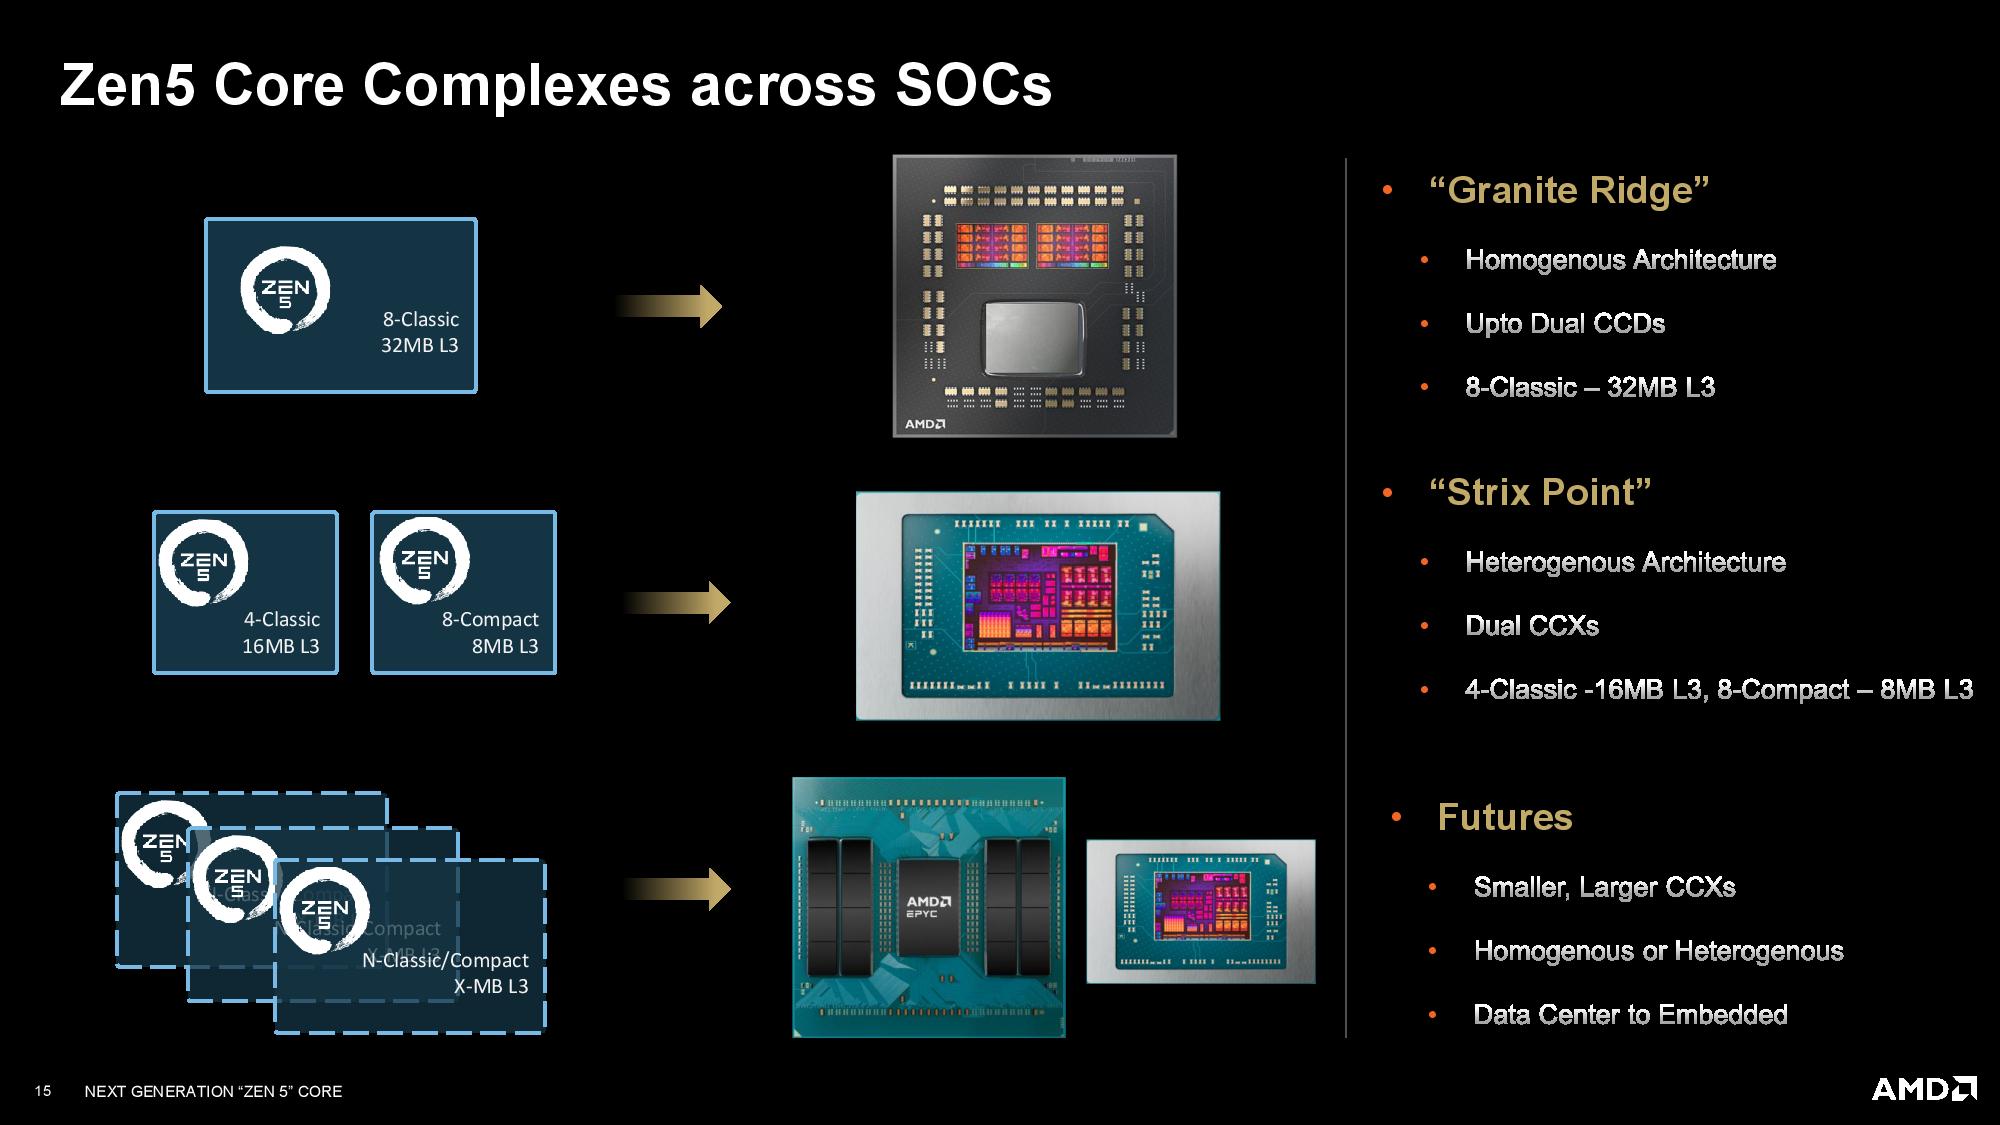
A AMD desenvolveu a arquitetura Zen 5 e depois a customizou para uma implementação mais compacta em seus núcleos Zen 5c. Esta arquitetura única, implantada em dois tipos de núcleos personalizáveis, será usada para seus processadores de desktop, móveis e servidores, abrangendo tanto os nós de processo de 4nm quanto de 3nm.
A abordagem da AMD para seus núcleos ‘compactos’ Zen 5c é intrinsecamente diferente da abordagem da Intel com seus e-cores. Como os E-cores da Intel, os núcleos Zen 5c da AMD são projetados para consumir menos espaço em um chip do que os núcleos de desempenho ‘padrão’, enquanto oferecem desempenho suficiente para tarefas menos exigentes, economizando energia e fornecendo mais potência de computação por milímetro quadrado do que era possível anteriormente (leia mais aqui).
Os núcleos Zen 5 e Zen 5c da AMD podem ser usados em vários segmentos, em designs heterogêneos com ambos os tipos de núcleos no mesmo chip (como o Strix Point) ou designs homogêneos que usam apenas um tipo de núcleo (como os chips de desktop Granite Ridge com apenas núcleos de tamanho completo, ou os chips de servidor EPYC Bergamo da geração anterior com apenas núcleos compactos menores).
O SoC Ryzen 9000 Granite Ridge é exatamente como esperado — um único CCD contém oito núcleos Zen 5 completos emparelhados com 32MB de cache L3.
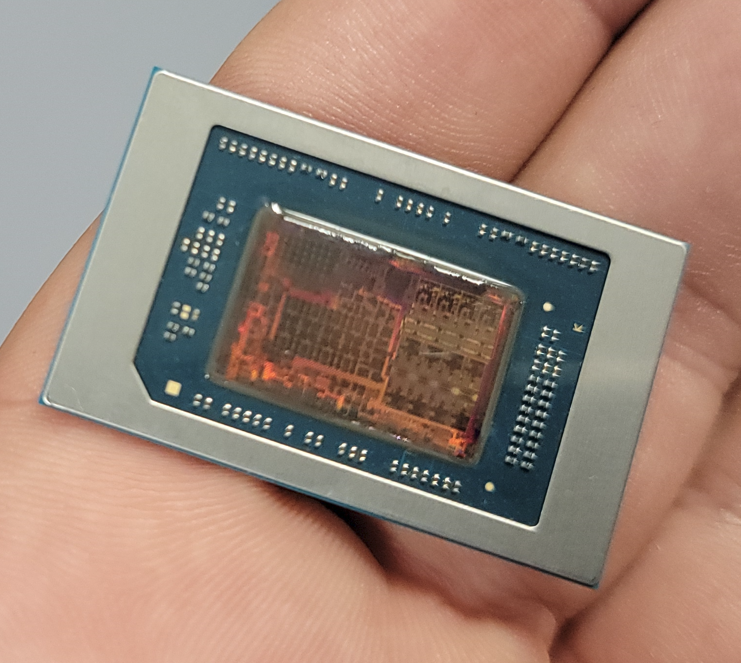
No entanto, o SoC Strix Point é completamente único. Os núcleos compactos são projetados para desempenho escalável, proporcionando uma relação potência-desempenho mais otimizada. Isso significa que a AMD adota uma abordagem diferente com as capacidades de cache para este tipo de núcleo. O chip tem dois CCXs (Core Complexes — clusters de núcleos no mesmo chip), como vimos nos chips AMD Zen 2 mais antigos.
Ambos os tipos de núcleos têm seus próprios caches L1 e L2 privados, mas os 24MB de cache L3 são divididos em uma fatia de 8MB para os núcleos padrão e uma fatia de 16MB para os núcleos compactos Zen 5c. Os núcleos Zen 5c da AMD marcam a primeira vez que a empresa possui dois tipos de núcleos com diferentes capacidades de cache no mesmo chip — os quatro núcleos de desempenho de tamanho completo têm 4MB de L3 cada para satisfazer cargas de trabalho de baixa latência e explosivas. Em contraste, os oito núcleos compactos têm apenas 1MB de L3 cada para cargas de trabalho de baixa utilização e alta residência.
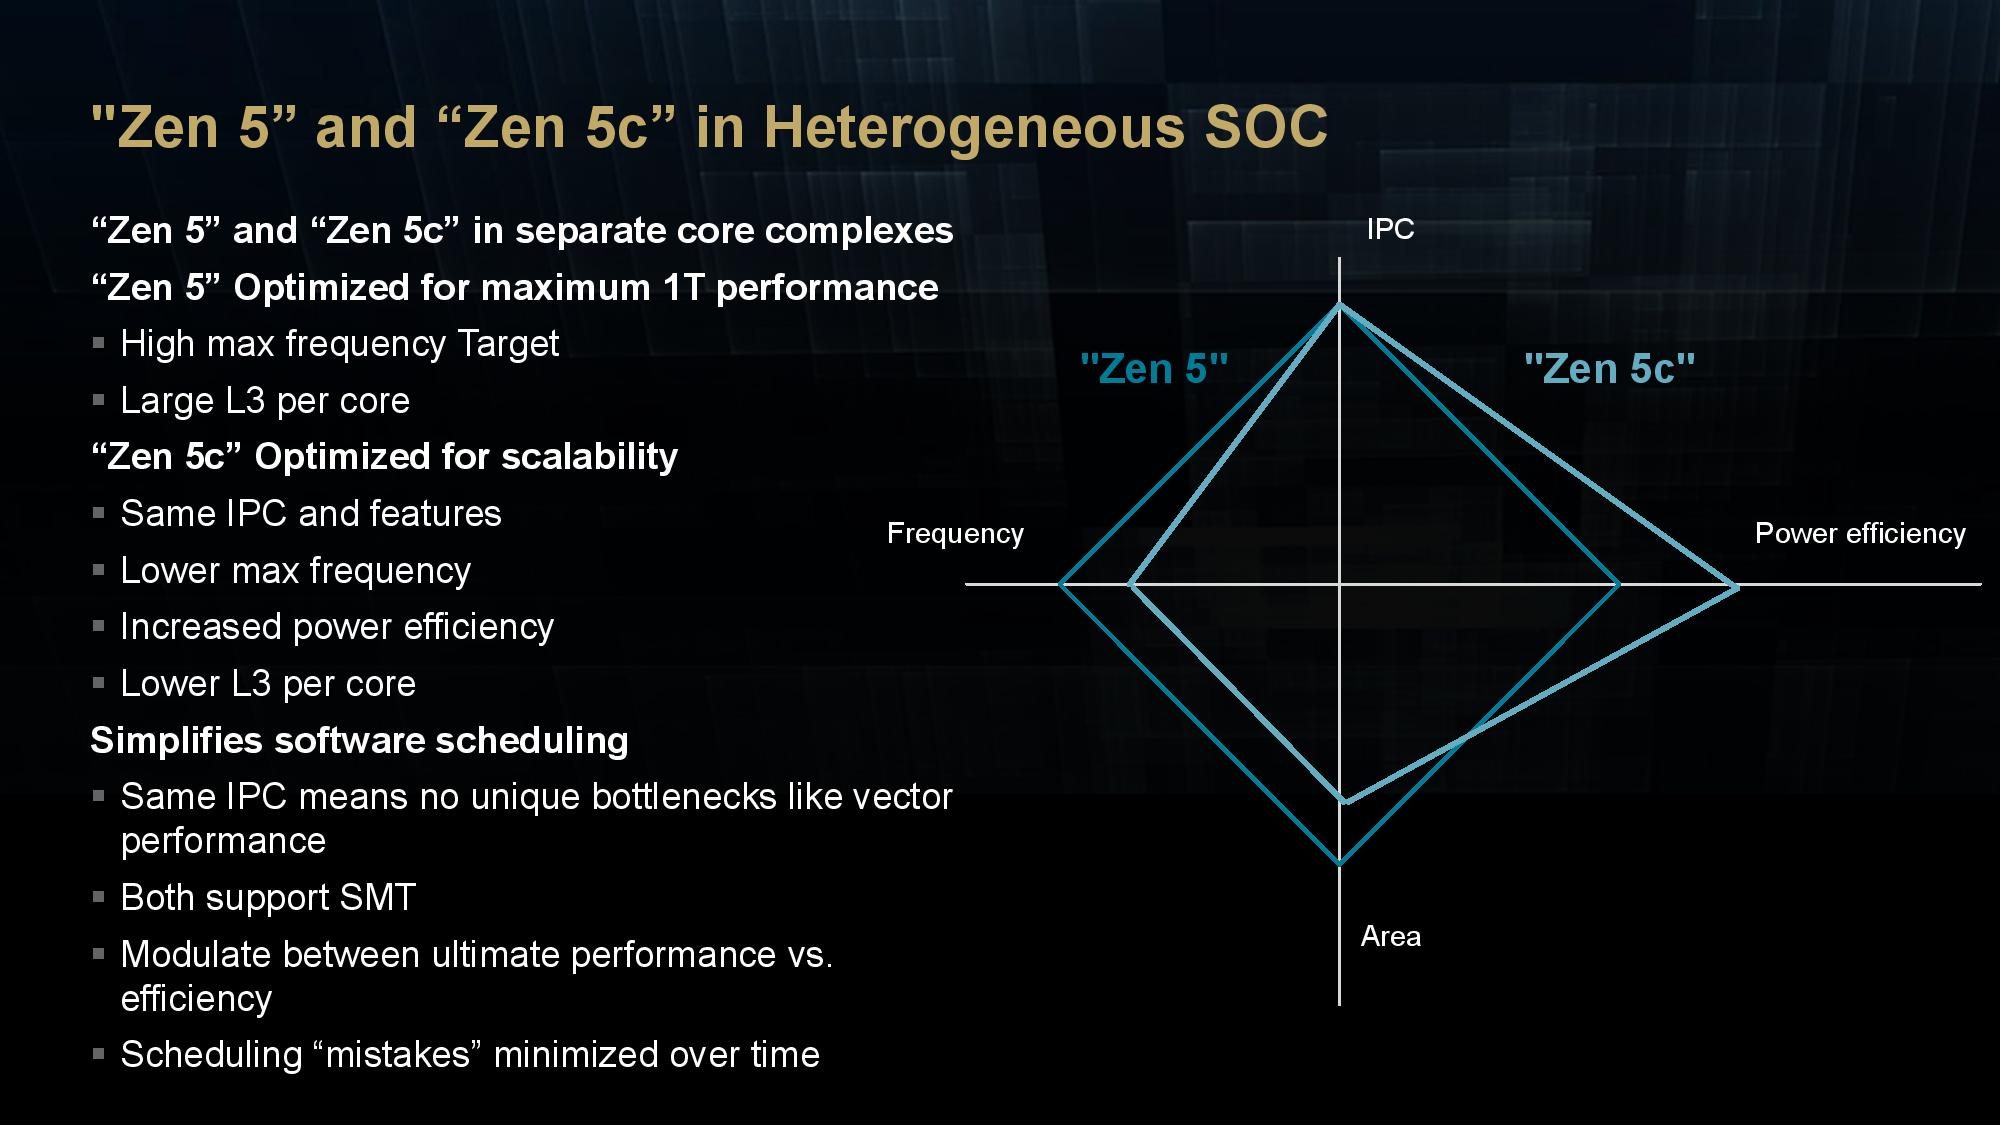
A redução da capacidade do cache L3 não apenas economiza área para os núcleos compactos, mas também reduz drasticamente o consumo de energia — o chip usa muito menos cache por núcleo compacto. Dado que a AMD gostaria de operar toda a máquina em núcleos compactos o máximo possível enquanto desativa os núcleos de desempenho e seus grandes caches L3, isso tem um potencial tremendo para aumentar a vida útil da bateria — desde que os mecanismos de agendamento funcionem conforme o esperado.
A mudança para um design de cache assimétrico apresenta novos problemas de gerenciamento para a AMD. Esses dois caches L3 devem se comunicar entre si através do tecido de dados, semelhante ao mecanismo de coerência de cache CCX para CCX encontrado na arquitetura Zen 2 mais antiga da AMD. Isso introduz uma latência maior para transferências de cache para cache, que a AMD diz ser “não mais do que você teria que ir para a memória”.
Como tal, a AMD usa mecanismos de agendamento do Windows para tentar restringir as cargas de trabalho aos núcleos Zen 5 ou 5c para reduzir a ocorrência de transferências de alta latência, com cargas de trabalho em segundo plano geralmente sendo atribuídas aos núcleos 5c.
Ao contrário da Intel, que prioriza o agendamento do trabalho em seus e-cores primeiro antes de enviá-lo para outros núcleos se os núcleos menores não forem rápidos o suficiente, a AMD não tem preferência por onde a carga de trabalho é alocada primeiro. Em vez disso, a AMD permite que o sistema operacional escolha o tipo de núcleo a ser direcionado com base em mecanismos de prioridade e QoS, garantindo assim a melhor experiência de usuário possível com base na carga de trabalho.
A AMD também expandiu sua justificativa e objetivos para os núcleos compactos Zen 5c. Ao contrário da abordagem da Intel, ambos os tipos de núcleo Zen 5 suportam SMT e o mesmo conjunto de instruções (ISA), evitando os problemas de agendamento que a Intel enfrenta com seus tipos de núcleo diferentes (os tipos de núcleo da Intel não suportam o mesmo ISA).
A abordagem da AMD também difere da Intel porque prioriza manter o desempenho dos núcleos Zen 5c o mais próximo possível dos núcleos padrão durante cargas de trabalho multi-core. Isso evita situações em que os núcleos maiores estão esperando que os núcleos menores concluam as cargas de trabalho (importante para situações como cargas de trabalho multi-core com dependências de thread). Isso evita o que Mike Clark, arquiteto líder do Zen, chama de ‘penhasco de agendamento’, onde uma grande diferença de desempenho ocorrerá se uma carga de trabalho for agendada em um núcleo Zen 5c, impactando negativamente a experiência do usuário.
Em última análise, o objetivo é fornecer o menor delta possível entre os dois tipos de núcleo. Então, em vez de definir o alvo de design do Zen 5c previsto por um determinado requisito de área de chip, a AMD mirou um certo gráfico de tensão/frequência (V/F) para os núcleos menores.
Reduzir a meta de frequência do Zen 5c permitiu à empresa dividir o design em blocos maiores e menos numerosos que são colocados mais próximos, o que confere benefícios de redução de energia. A AMD removeu o circuito de repetidor de alta velocidade e buffer que não era mais necessário nos núcleos 5c para atingir as frequências máximas suportadas pelos núcleos padrão. Combinado com a menor capacidade de cache L3 por núcleo, a área do chip do Zen 5c foi reduzida tremendamente em comparação com os núcleos padrão. (Você pode ler mais sobre isso em nossa entrevista com Clark aqui.)
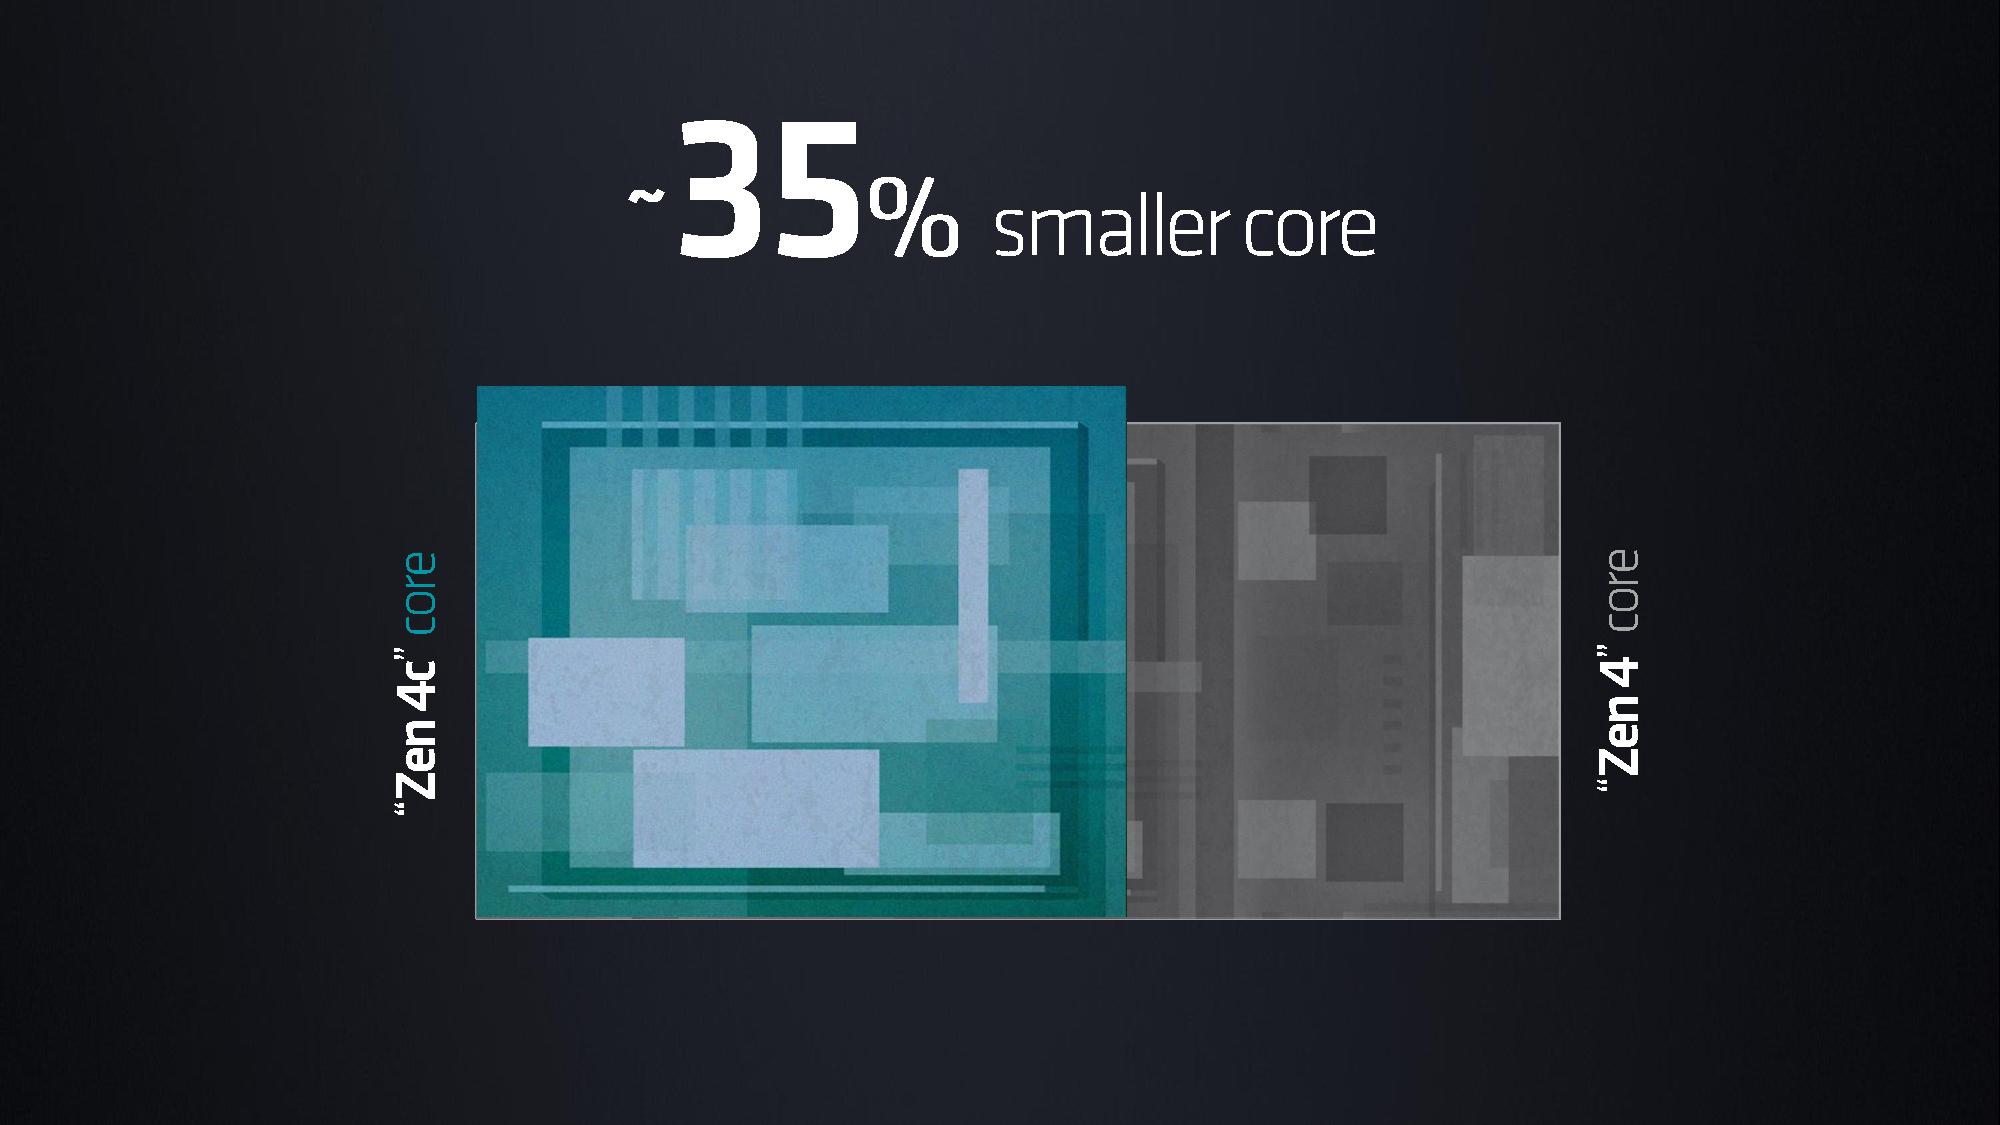
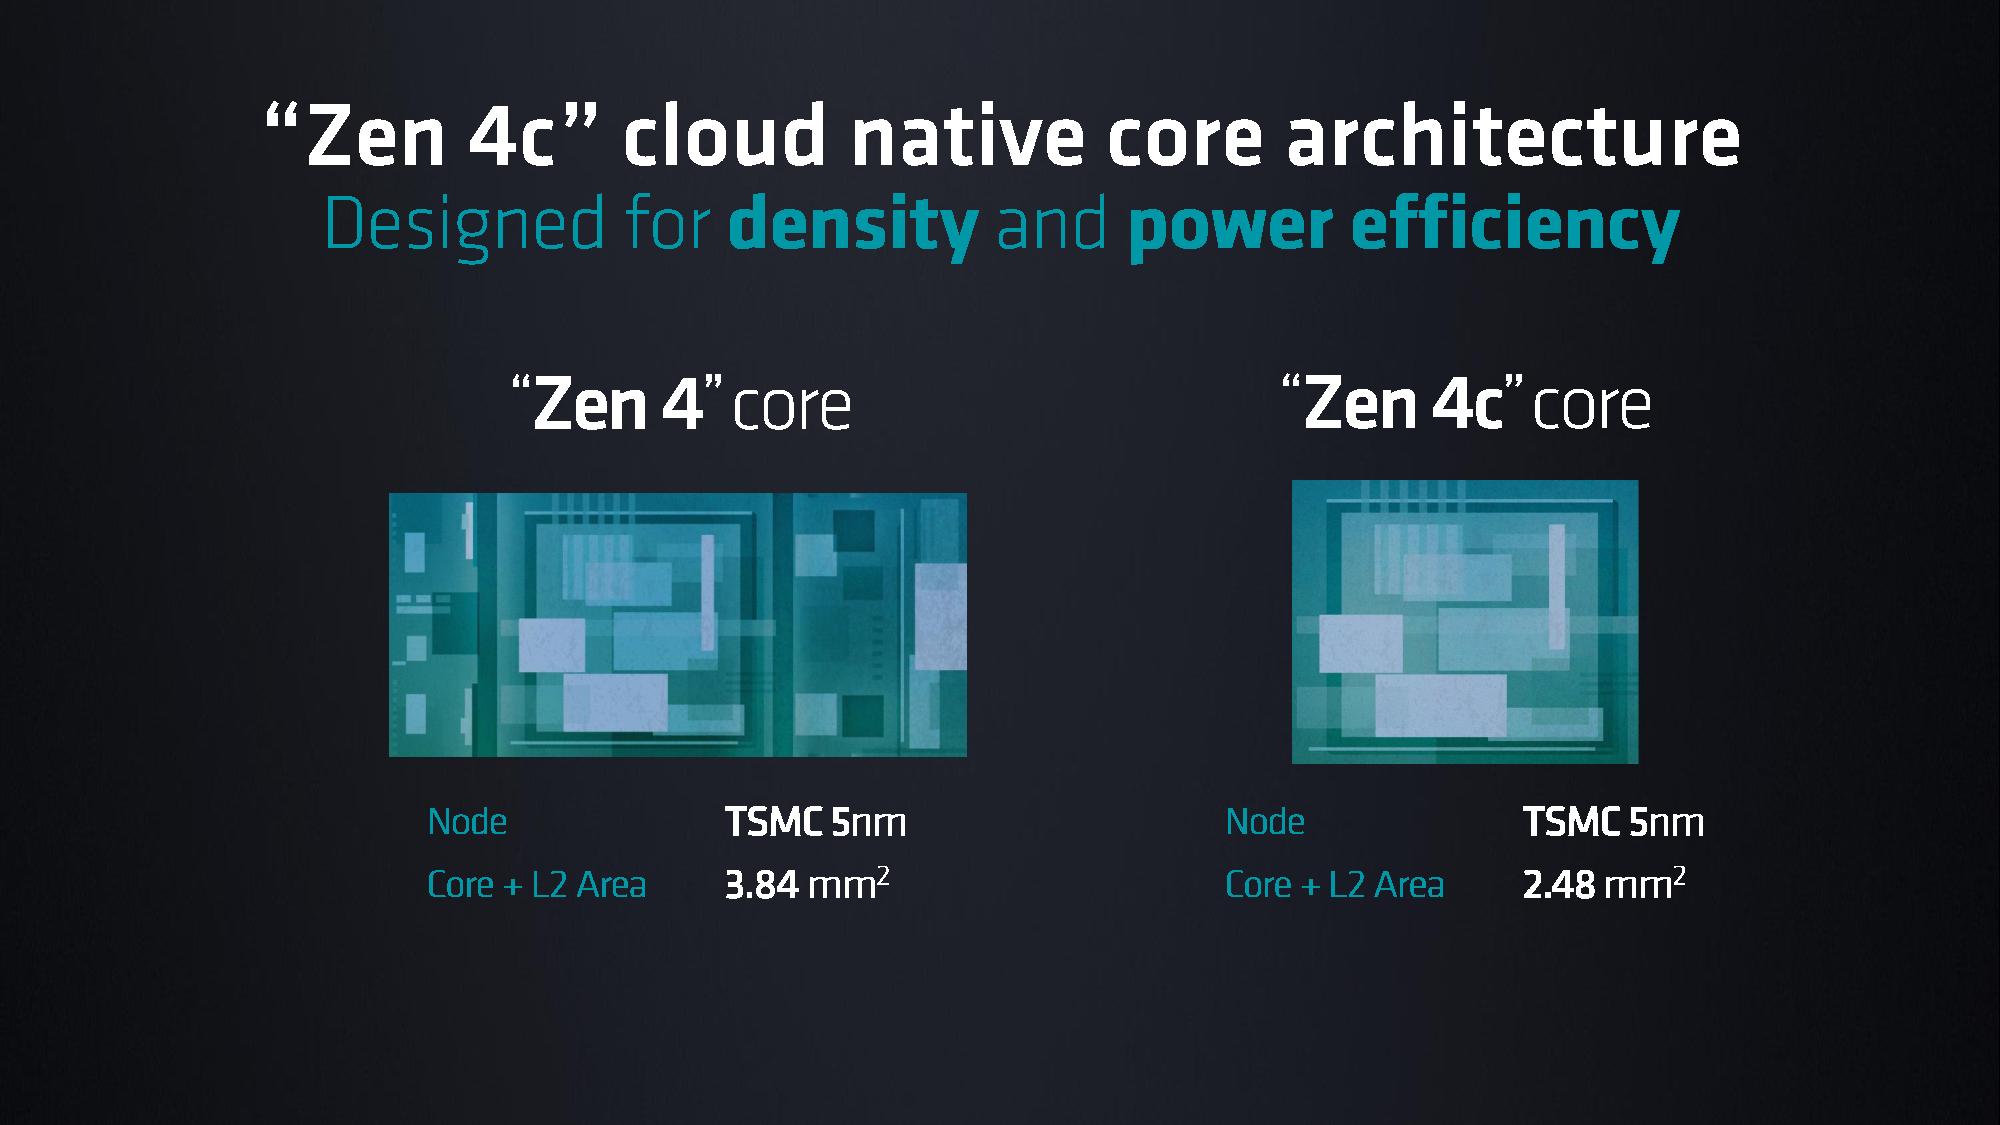
No final, a AMD reduziu a área dos núcleos Zen 5c em cerca de 25% em comparação com os núcleos Zen 5 padrão (Clark observa que isso é uma estimativa aproximada). Isso é menos do que a redução de 35% que vimos com os núcleos Zen 4c usados nos processadores EPYC Bergamo (slide acima para referência).
Clark disse que o núcleo Zen 5 poderia ser ainda mais compactado para designs apenas de núcleos compactos (homogêneos) com diferentes metas de desempenho (para referência, o Bergamo tem apenas núcleos compactos), mas este design atende às metas para este design heterogêneo específico. Portanto, podemos ver designs de núcleo Zen 5c ainda mais densos surgirem com outros produtos.
Não se engane, uma redução de 25% na área do núcleo para o Zen 5c é impressionante, especialmente se a AMD conseguiu manter os deltas de desempenho entre os núcleos baixos. No entanto, apenas os testes dirão. Também não conseguimos encontrar as frequências dos núcleos Zen 5c listadas no site da AMD, mas estamos acompanhando para obter mais detalhes.
AMD Strix Point SoC
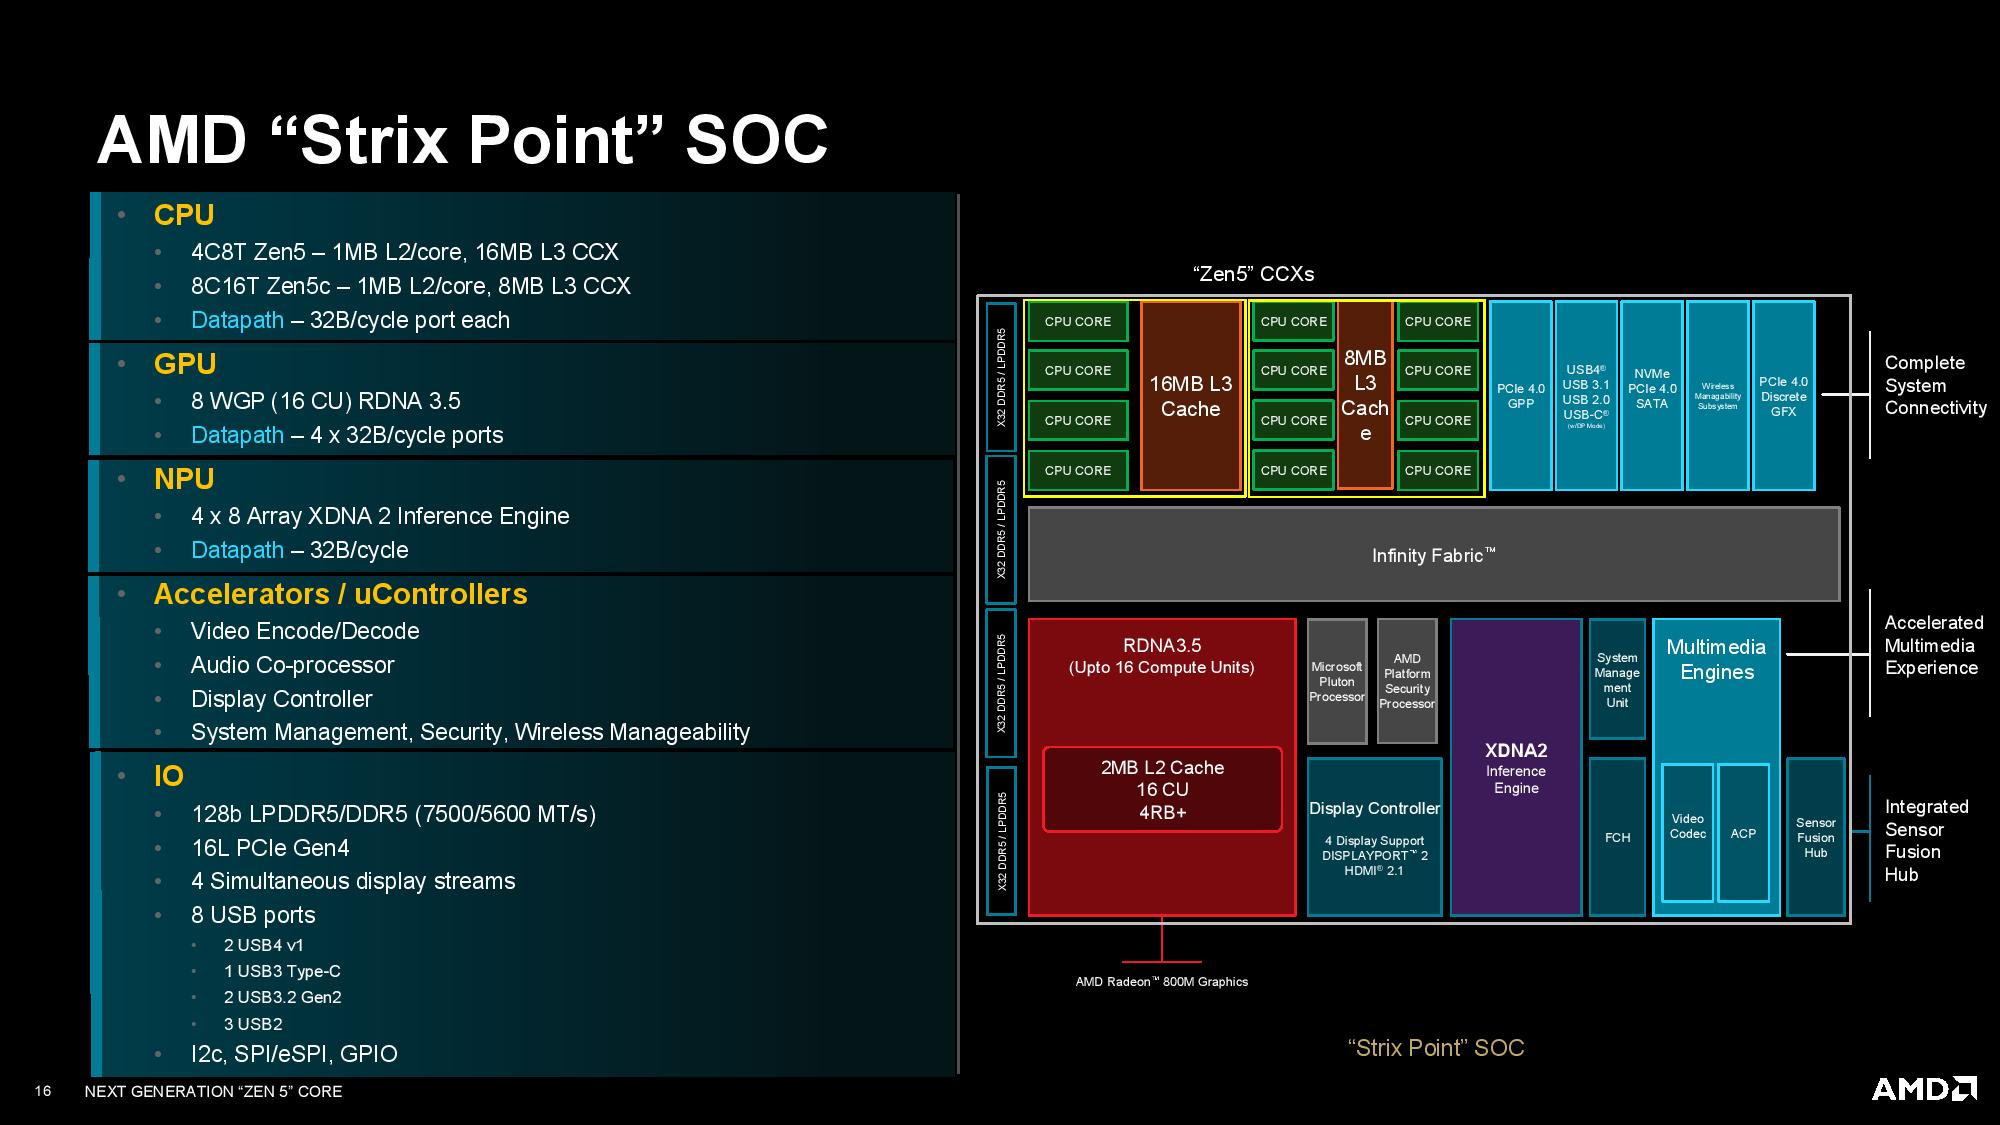
Aqui, podemos ver uma análise mais detalhada do SoC Strix Point. Os detalhes mais interessantes são as várias larguras de caminho de dados entre as diferentes unidades de computação. Esses caminhos de dados se comunicam com a memória via Infinity Fabric.
Ambos os clusters de núcleos Zen 5 e Zen 5c têm sua própria porta de 32B/ciclo, o que significa que as transferências de cache para cache entre os CCXs terão limitações.
Enquanto isso, a GPU faminta por largura de banda tem quatro portas de 32B/ciclo. A unidade de processamento neural (NPU) XDNA também tem sua própria interface de 32B/ciclo para o tecido de dados.
Também vemos o complemento padrão de blocos aceleradores de função fixa, como codificação/decodificação de vídeo e similares. O Strix suporta memória LPDDR5-7500 e DDR5-5600.
Notavelmente, a AMD reduziu a alocação de pistas PCIe. Como é costume com suas partes móveis, a AMD retrocede para uma interface PCIe de geração anterior — neste caso, PCIe 4.0 — para economizar energia. No entanto, a AMD também reduziu de 20 pistas de conectividade para 16, dizendo que essa decisão foi tomada porque a empresa determinou que as quatro pistas extras quase sempre eram usadas para armazenamento secundário. No entanto, a AMD diz que esse caso de uso não é comum neste segmento (taxa de anexação baixa). Como tal, a AMD determinou que reduzir o número de pistas era uma troca aceitável que resultou em uma redução na contagem de pinos que ajudou a economizar área do chip e do substrato (conexões reduzidas para o chip e a placa do sistema) enquanto reduzia ainda mais a energia.
AMD Granite Ridge SoC
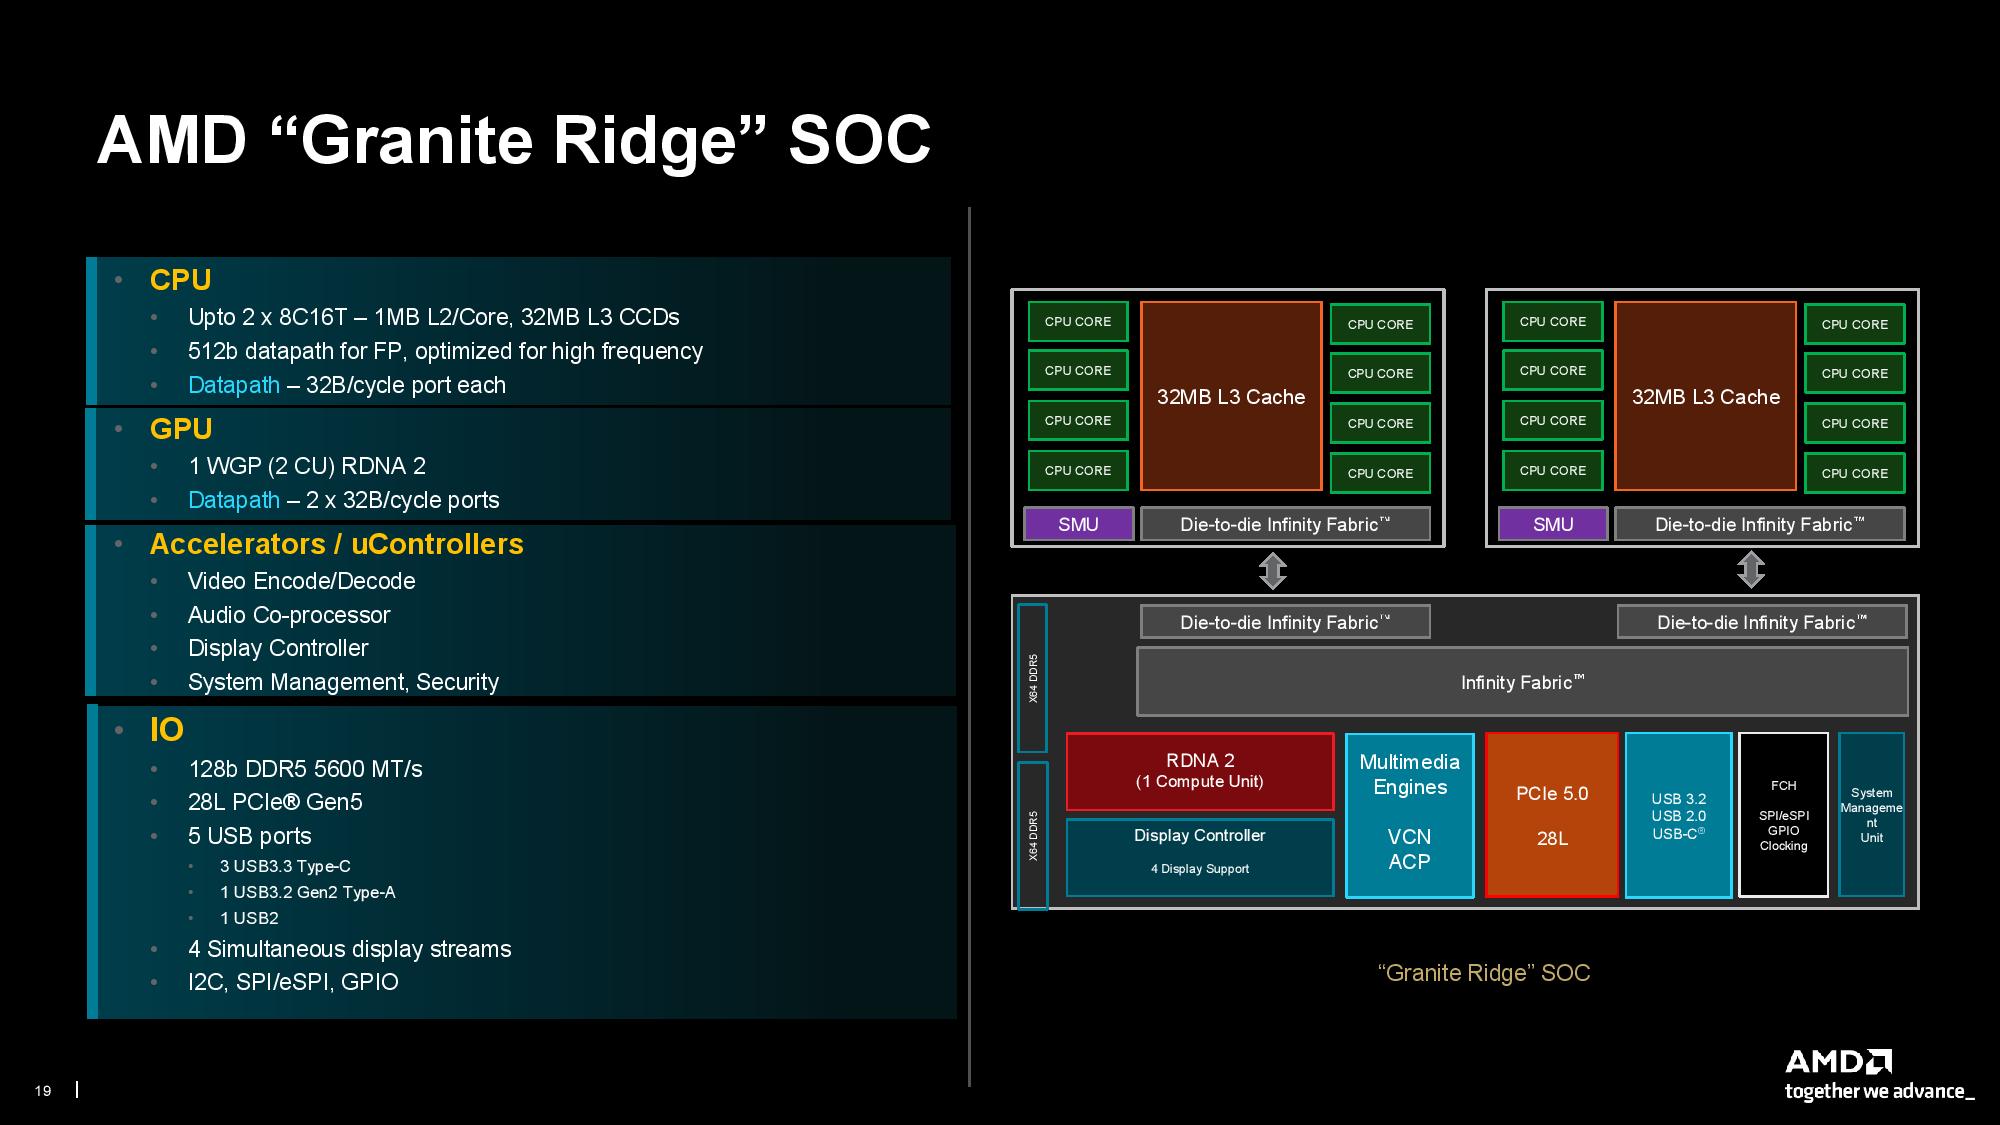
O SoC Granite Ridge nos chips de desktop Ryzen 9000 tem menos surpresas — o layout é semelhante aos chips da geração anterior. Na verdade, o SoC usa o mesmo I/O Die (IOD) que os chips Zen 4 Ryzen 7000. Isso significa o mesmo suporte para memória DDR5-5600, 28 pistas de PCIe 5.0, cinco portas USB e quatro streams de display da engine gráfica RDNA 2.
Usar o mesmo IOD segue a política padrão da AMD de reutilização inteligente sempre que possível. A engine RDNA 2 é suficiente para os propósitos da AMD — é realmente apenas para iluminar uma tela e nada mais. Também permite que a AMD mantenha o mesmo tamanho de pacote de antes, facilitando seu esforço para continuar a apoiar a plataforma AM5. A iGPU tem portas duplas de 32B/ciclo para o Infinity Fabric.
O IOD é emparelhado com um ou dois dies de complexo de núcleo de oito núcleos (CCDs). Processadores com um único CCD têm uma porta de leitura/gravação de 32B/ciclo para comunicação com o IOD via conexão Infinity Fabric die-to-die (D2D). No entanto, como antes, chips de dois CCDs têm uma conexão de gravação de 16B/ciclo e leitura de 32B/ciclo entre os IODs para economizar energia no SERDES de alta potência e também facilitar o layout do pacote (o tamanho da interface é importante aqui, pois o design é mais restrito em espaço com dois dies). A AMD diz que caracterizou cargas de trabalho do mundo real e encontrou uma proporção típica de 3 para 1 de leituras para gravações, então o desempenho é amplamente não impactado pela largura de banda de gravação reduzida de 16B/ciclo.
O CCD Granite Ridge ‘Eldora’ embala 8,315 bilhões de transistores TSMC N4P em 70,6mm² de silício, equivalendo a uma densidade de transistores de 117,78 MTr/mm² — um aumento de 28% na densidade em relação ao CCD Durango do Zen 4.
O Strix Point tem um die de 232,5mm², muito maior do que o die de 178mm² encontrado no Hawk Point da geração anterior. Isso se deve em grande parte ao fato de que ambos os dies usam o mesmo nó de processo, mas o Strix tem mais núcleos e cache. A AMD ainda não compartilhou a contagem de transistores para o Strix, mas estamos acompanhando para obter mais detalhes. Por enquanto, você pode ler mais sobre a análise do die Zen 5 aqui.