

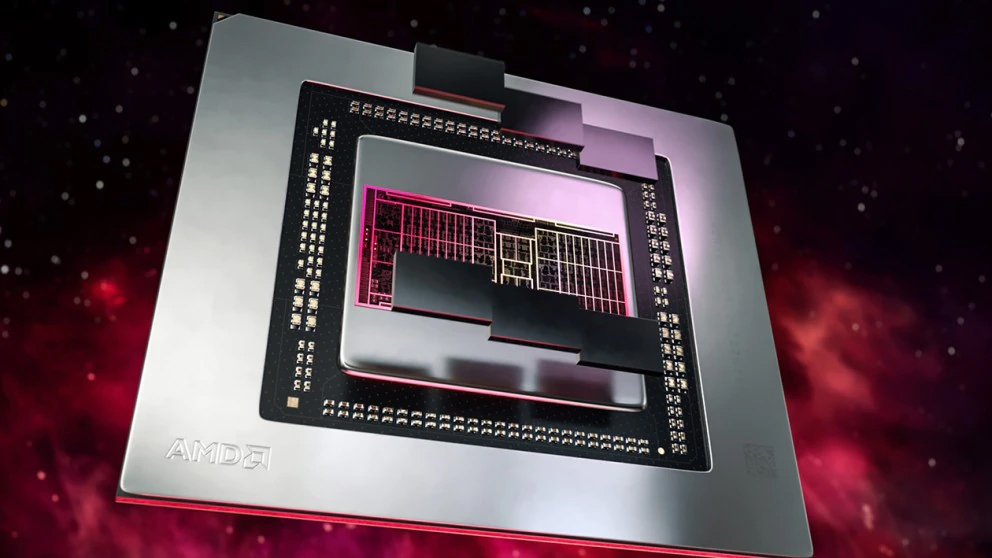
Aqui em Berlim, Alemanha, na IFA 2024, Jack Huynh, vice-presidente sênior e gerente geral do Grupo de Negócios de Computação e Gráficos da AMD, anunciou que a empresa unificará suas arquiteturas RDNA, focada no consumidor, e CDNA, voltada para data centers, em uma única microarquitetura chamada UDNA. Essa mudança visa enfrentar de forma mais eficaz o ecossistema CUDA da Nvidia. A decisão de AMD ocorre enquanto a empresa opta por despriorizar placas gráficas de jogos de alto desempenho para acelerar o ganho de participação de mercado.
Quando a AMD abandonou sua microarquitetura GCN em 2019, a empresa decidiu dividir sua nova microarquitetura gráfica em dois designs diferentes: RDNA para produtos gráficos de jogos para o mercado consumidor e CDNA para cargas de trabalho de IA e HPC em data centers.
Huynh explicou a razão por trás da divisão em uma sessão de perguntas e respostas com a imprensa e o motivo para avançar com um novo design unificado. Aqui está uma transcrição levemente editada das conversas:
Jack Huynh [JH], AMD: Então, parte de uma grande mudança na AMD é que hoje temos uma arquitetura CDNA para nossas GPUs de data center Instinct e RDNA para o consumidor. Está dividido. No futuro, chamaremos de UDNA. Haverá uma arquitetura unificada, tanto Instinct quanto cliente [consumidor]. Vamos unificá-la para que seja muito mais fácil para os desenvolvedores, ao contrário de hoje, onde eles têm que escolher e o valor não está melhorando.
Dividimos porque então você obtém sub-otimizações e micro-otimizações, mas é muito difícil para esses desenvolvedores, especialmente à medida que estamos crescendo nosso negócio de data center, então agora precisamos unificá-la. Isso tem sido parte disso. Porque lembra o que eu disse antes? Estou pensando em milhões de desenvolvedores; é onde queremos chegar. O primeiro passo é chegar às centenas, milhares, dezenas de milhares, centenas de milhares e, com sorte, um dia, milhões. É isso que estou dizendo à equipe agora. É essa escala que temos que construir agora.
Tom’s Hardware [TH], Paul Alcorn: Então, com o UDNA reunindo essas arquiteturas, tudo isso ainda será compatível com a divisão RDNA e CDNA?
JH: Então, uma das coisas que queremos fazer é… cometemos alguns erros com o lado RDNA; cada vez que mudamos a hierarquia de memória, o subsistema, ele tem que redefinir a matriz nas otimizações. Eu não quero fazer isso.
Então, no futuro, estamos pensando não apenas em RDNA 5, RDNA 6, RDNA 7, mas UDNA 6 e UDNA 7. Planejamos as próximas três gerações porque, uma vez que obtemos as otimizações, não quero ter que mudar a hierarquia de memória e, em seguida, perder muitas otimizações. Então, estamos meio que forçando essa questão de compatibilidade total para frente e para trás. Fazemos isso no Xbox hoje; é muito viável, mas requer planejamento avançado. É muito mais trabalho, mas é a direção que estamos indo.
PA: Quando você traz isso de volta a uma arquitetura unificada, isso significa, só para esclarecer, que uma GPU de desktop teria a mesma arquitetura que um MI300X equivalente no futuro? Correto?
JH: É uma estratégia de nuvem para cliente. E acho que isso nos permitirá ser muito eficientes também. Então, em vez de ter duas equipes fazendo isso, você tem uma equipe. Não é algo tão louco, certo? Dividimos porque queríamos micro-otimizar no curto prazo, mas agora que temos escala, temos que unificar de volta, e acredito que é a abordagem certa. Pode haver alguns pequenos obstáculos.
PA: Então, essa fusão de volta, quanto tempo levará? Quantas gerações de produtos antes de vermos isso?
JH: Ainda não divulgamos isso. É uma estratégia. Estratégia é muito importante para mim. Acho que é a estratégia certa. Temos que garantir que estamos fazendo a coisa certa. Na verdade, quando falamos com os desenvolvedores, eles adoram porque, novamente, eles têm todos esses outros departamentos dizendo-lhes para fazer coisas diferentes também. Então, preciso reduzir a complexidade.
[Fim dos comentários de Huynh]
Sim, o silício de alto desempenho pode construir mercados, mas, em última análise, o suporte de software tende a declarar os vencedores e perdedores. A Nvidia ensinou a aula magistral de como construir um fosso aparentemente impenetrável com seu ecossistema proprietário CUDA inigualável.
A Nvidia começou a lançar os alicerces de seu império quando começou com o CUDA há dezoito longos anos, e talvez uma de suas vantagens mais fundamentais seja simbolizada no ‘U’ do CUDA, a Compute Unified Device Architecture. A Nvidia tem apenas uma plataforma CUDA para todos os usos e aproveita as mesmas microarquiteturas subjacentes para IA, HPC e jogos.
Huynh me disse que o CUDA tem quatro milhões de desenvolvedores, e seu objetivo é pavimentar o caminho para que a AMD veja um sucesso semelhante. Isso é uma tarefa difícil. A AMD continua a confiar na pilha de software de código aberto ROCm para combater a Nvidia, mas isso requer a adesão tanto dos usuários quanto da comunidade de código aberto que assumirá parte do ônus de otimizar a pilha. Qualquer coisa que a AMD possa fazer para simplificar esse trabalho, mesmo que venha ao custo de algumas micro-otimizações para certos tipos de aplicativos/jogos, ajudará a acelerar esse ecossistema.
A AMD tem recebido sua cota de críticas pela eficácia muitas vezes dispersa da pilha ROCm. Quando comprou a Xilinx em 2022, a AMD até anunciou que colocaria Victor Peng, então CEO da Xilinx, no comando de uma equipe unificada do ROCm para trazer o projeto sob controle mais rígido (Peng se aposentou recentemente). Esse esforço rendeu pelo menos alguns frutos, mas a AMD continua a receber críticas pelo estado de sua pilha ROCm – é claro que a empresa tem muito trabalho pela frente para se colocar totalmente em uma posição de enfrentar o CUDA da Nvidia.
A empresa também permanece focada no ROCm, apesar do surgimento da UXL Foundation, um ecossistema de software aberto para aceleradores que está recebendo amplo apoio de outros players da indústria, como Qualcomm, Samsung, Arm e Intel.
O que exatamente o UDNA mudará em comparação com a divisão atual entre RDNA e CDNA? Huynh não entrou em muitos detalhes, e obviamente ainda há muito trabalho a ser feito. Mas um ponto de dor claro tem sido a falta de unidades de aceleração de IA dedicadas no RDNA. A Nvidia trouxe núcleos tensor para toda a linha RTX a partir de 2018. A AMD só tem aceleração limitada de IA no RDNA 3, basicamente acessando as unidades FP16 de forma mais otimizada via instruções WMMA, enquanto o RDNA 2 depende puramente dos shaders da GPU para esse trabalho.
Assumimos que, em algum momento, a AMD trará suporte completo para operações tensor para suas GPUs com UDNA. O CDNA tem tido essas unidades funcionais desde 2020, com maior taxa de transferência e suporte a formatos numéricos sendo adicionados com CDNA 2 (2021) e CDNA 3 (2023). Dada a preponderância do trabalho de IA sendo feito tanto em data centers quanto em GPUs de clientes hoje em dia, adicionar suporte a tensor para GPUs de clientes parece uma necessidade crítica.
A arquitetura unificada UDNA é um bom próximo passo lógico na jornada para competir com o CUDA, mas a AMD tem uma montanha a escalar. Huynh não se comprometeu com uma data de lançamento para a nova arquitetura, mas, dado os bilhões de dólares em jogo no mercado de IA, obviamente será uma prioridade executar a nova estratégia microarquitetônica. Ainda assim, com o que ouvimos sobre AMD RDNA 4, parece que o UDNA está pelo menos a uma geração de distância.
Fonte: Tom’s Hardware