


A série Radeon RX 7000 da AMD e a arquitetura RDNA 3 foram lançadas no final de 2022, começando com as RX 7900 XTX e RX 7900 XT. Nos últimos meses, várias outras placas foram adicionadas à série, alimentando algumas das melhores placas gráficas. Você pode ver como as GPUs se comparam a outras gerações e concorrentes em nosso hierarquia de benchmarks de GPU, e agora estamos ansiosos para as futuras GPUs RDNA 4.
Mas vamos nos concentrar no presente. A linha completa de placas RDNA 3 da AMD consiste em sete modelos diferentes. Testamos e revisamos todos, desde a mais rápida RX 7900 XTX até a modesta RX 7600 e tudo mais.
AMD RDNA 3 / Navi 3x em Resumo
- Até 96 CUs / 12.288 shaders
- 50% melhor desempenho por watt em comparação com RDNA 2
- O dobro de ALUs por CU
- Arquitetura de chiplet de GPU
- Até 96MB de Infinity Cache
Especificações da série AMD RX 7000
Com todas as GPUs AMD RDNA 3 já lançadas e disponíveis globalmente, aqui estão as especificações principais.
A geração anterior de GPUs RDNA 2 e RX 6000 tinha quatro designs de GPU distribuídos em uma dúzia de modelos diferentes de placas gráficas. A AMD RDNA 3 simplifica um pouco as coisas, com três GPUs principais e sete modelos diferentes de placas gráficas (mais algumas versões integradas).
Os três designs de GPU são chamados de Navi 31, Navi 32 e Navi 33, indo do desempenho mais alto ao mais baixo. O maior die tem três modelos diferentes, enquanto os outros dois têm apenas dois modelos. Mas existem algumas diferenças significativas na forma como a AMD chega lá.
A AMD RDNA 3 usa chiplets de GPU pela primeira vez, pelo menos nas duas configurações principais. Navi 31 e 32 têm um grande GCD (Graphics Compute Die), com três a seis chiplets MCD (Memory Cache Die). O menor die, Navi 33, mantém o design monolítico tradicional.
Cada MCD oferece uma interface de memória de 64 bits e 16MB de cache L3. Os MCDs se conectam ao GCD principal via Infinity Fabric da AMD, usando o que a AMD chama de Infinity Fanout Bridge. Isso usa menos energia por bit do que outras interfaces externas, embora haja uma penalidade de energia em relação aos designs monolíticos. Na prática, a AMD economizou dinheiro nos custos de fabricação dos MCDs em um nó de processo da geração anterior, o que, por sua vez, reduz o tamanho do GCD.
Enquanto os designs futuros poderiam se beneficiar da divisão do die da GPU em vários chiplets, para esta primeira geração de chiplets de GPU, é basicamente uma medida de economia de custos. O die Navi 33, por sua vez, ainda usa N6, um refinamento do nó N7 usado com RDNA 2, porque é pequeno o suficiente para não valer a pena dividi-lo em um GCD mais dois MCDs.
As velocidades de clock não mudaram muito em relação ao RDNA 2, embora a AMD tenha dois domínios de clock diferentes desta vez — um para os shaders e outro para o front-end. As velocidades de clock declaradas pela AMD são um pouco conservadoras desta vez, o que significa que você geralmente verá clocks mais altos na maioria dos jogos. Mas há jogos em que você pode não atingir o clock de boost, que é o que listamos — a AMD também tem um “Game Clock” que é ainda mais conservador, mas na prática não é tão significativo.
Os CUs e os núcleos de shader receberam um grande upgrade nesta geração, mas curiosamente a AMD não chama diretamente cada um dos processadores ALU potenciais de shader. Em vez disso, lista um valor base que é metade da taxa efetiva. Então, por exemplo, os 6.144 shaders de GPU na RX 7900 XTX podem, às vezes, se comportar mais como 12.288 shaders. É daí que vem o cálculo muito mais alto, mais do que dobrando o que estava disponível com RDNA 2.
O modelo superior tem 61,4 teraflops de cálculo, e o dobro disso para cargas de trabalho FP16. Mesmo a RX 7800 XT de nível intermediário tem 37,3 teraflops de cálculo, o que quase dobra o que a RX 6800 XT oferecia. No entanto, o desempenho real em jogos não escala diretamente em proporção ao cálculo teórico. Então, por exemplo, a RX 7800 XT acaba se comportando de maneira muito semelhante à RX 6900 XT.
A largura de banda da memória na 7900 XTX aumentou mais de 50% em relação à RX 6950 XT. Isso se deve à mudança para uma interface 50% mais ampla, além de executar a memória GDDR6 a 20 Gbps (em comparação com 18 Gbps na 6950). A largura de banda efetiva da memória também melhora graças ao Infinity Cache de segunda geração, que para a maioria dos modelos diminuiu de tamanho em comparação com o RDNA 2. Mas isso é compensado principalmente por uma taxa de transferência mais alta e outros ajustes na hierarquia de cache.
Desempenho da AMD Radeon 7000

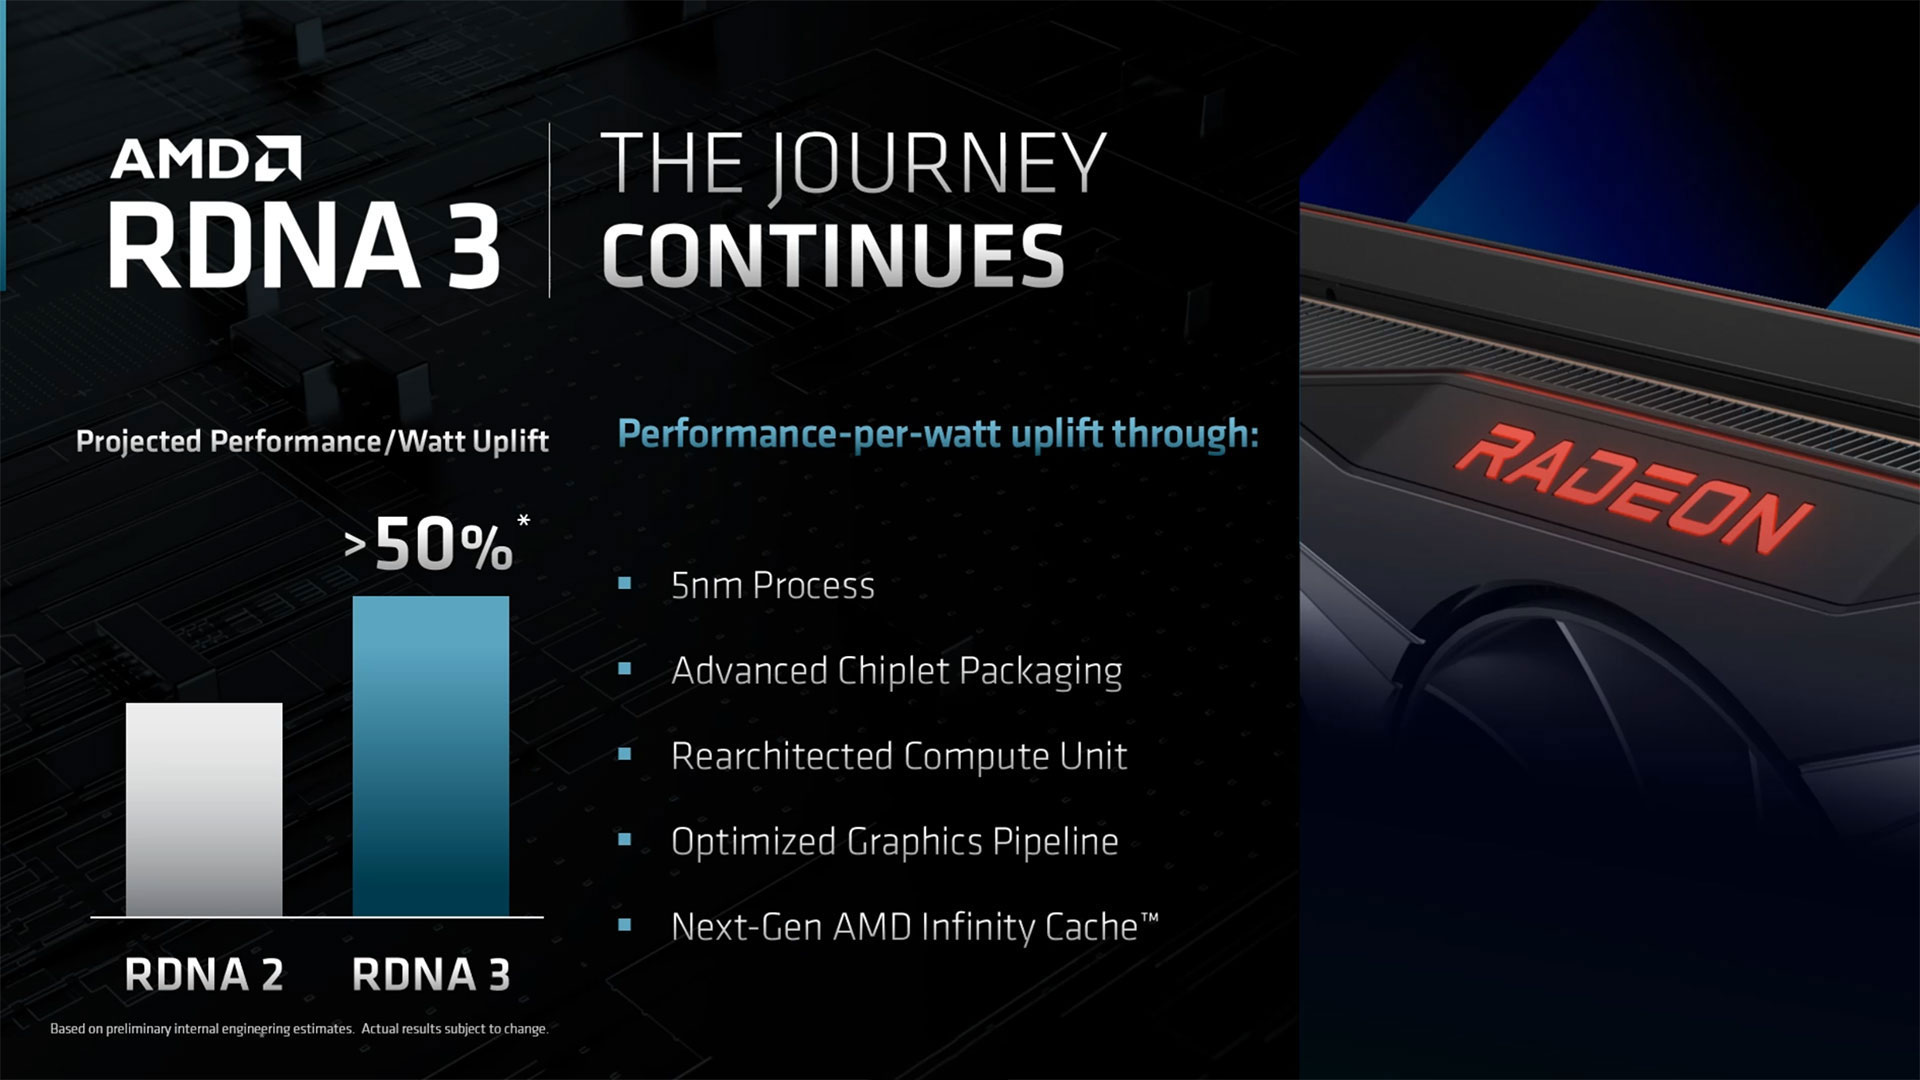
Como vimos com as duas últimas gerações de hardware da AMD, a empresa mirou em pelo menos uma melhoria de 50% no desempenho por watt com o RDNA 3. Embora isso possa parecer razoavelmente específico, deixa bastante margem de manobra. Por exemplo, o RDNA 2 entregou 50% melhor desempenho por watt do que o RDNA. Vamos dar alguns exemplos concretos de como isso se desenrolou.
De acordo com nossa hierarquia de benchmarks de GPU, a RX 6900 XT consome 308W de energia enquanto entrega 130 fps em 1080p ultra, 106 fps em 1440p ultra e 63 fps em 4K ultra. Uma RX 6700 XT de nível inferior usa 215W e tem uma média de 96 fps, 71 fps e 39 fps, enquanto a RX 5700 XT consome 214W enquanto entrega 74 fps, 53 fps e 29 fps nessas mesmas resoluções.

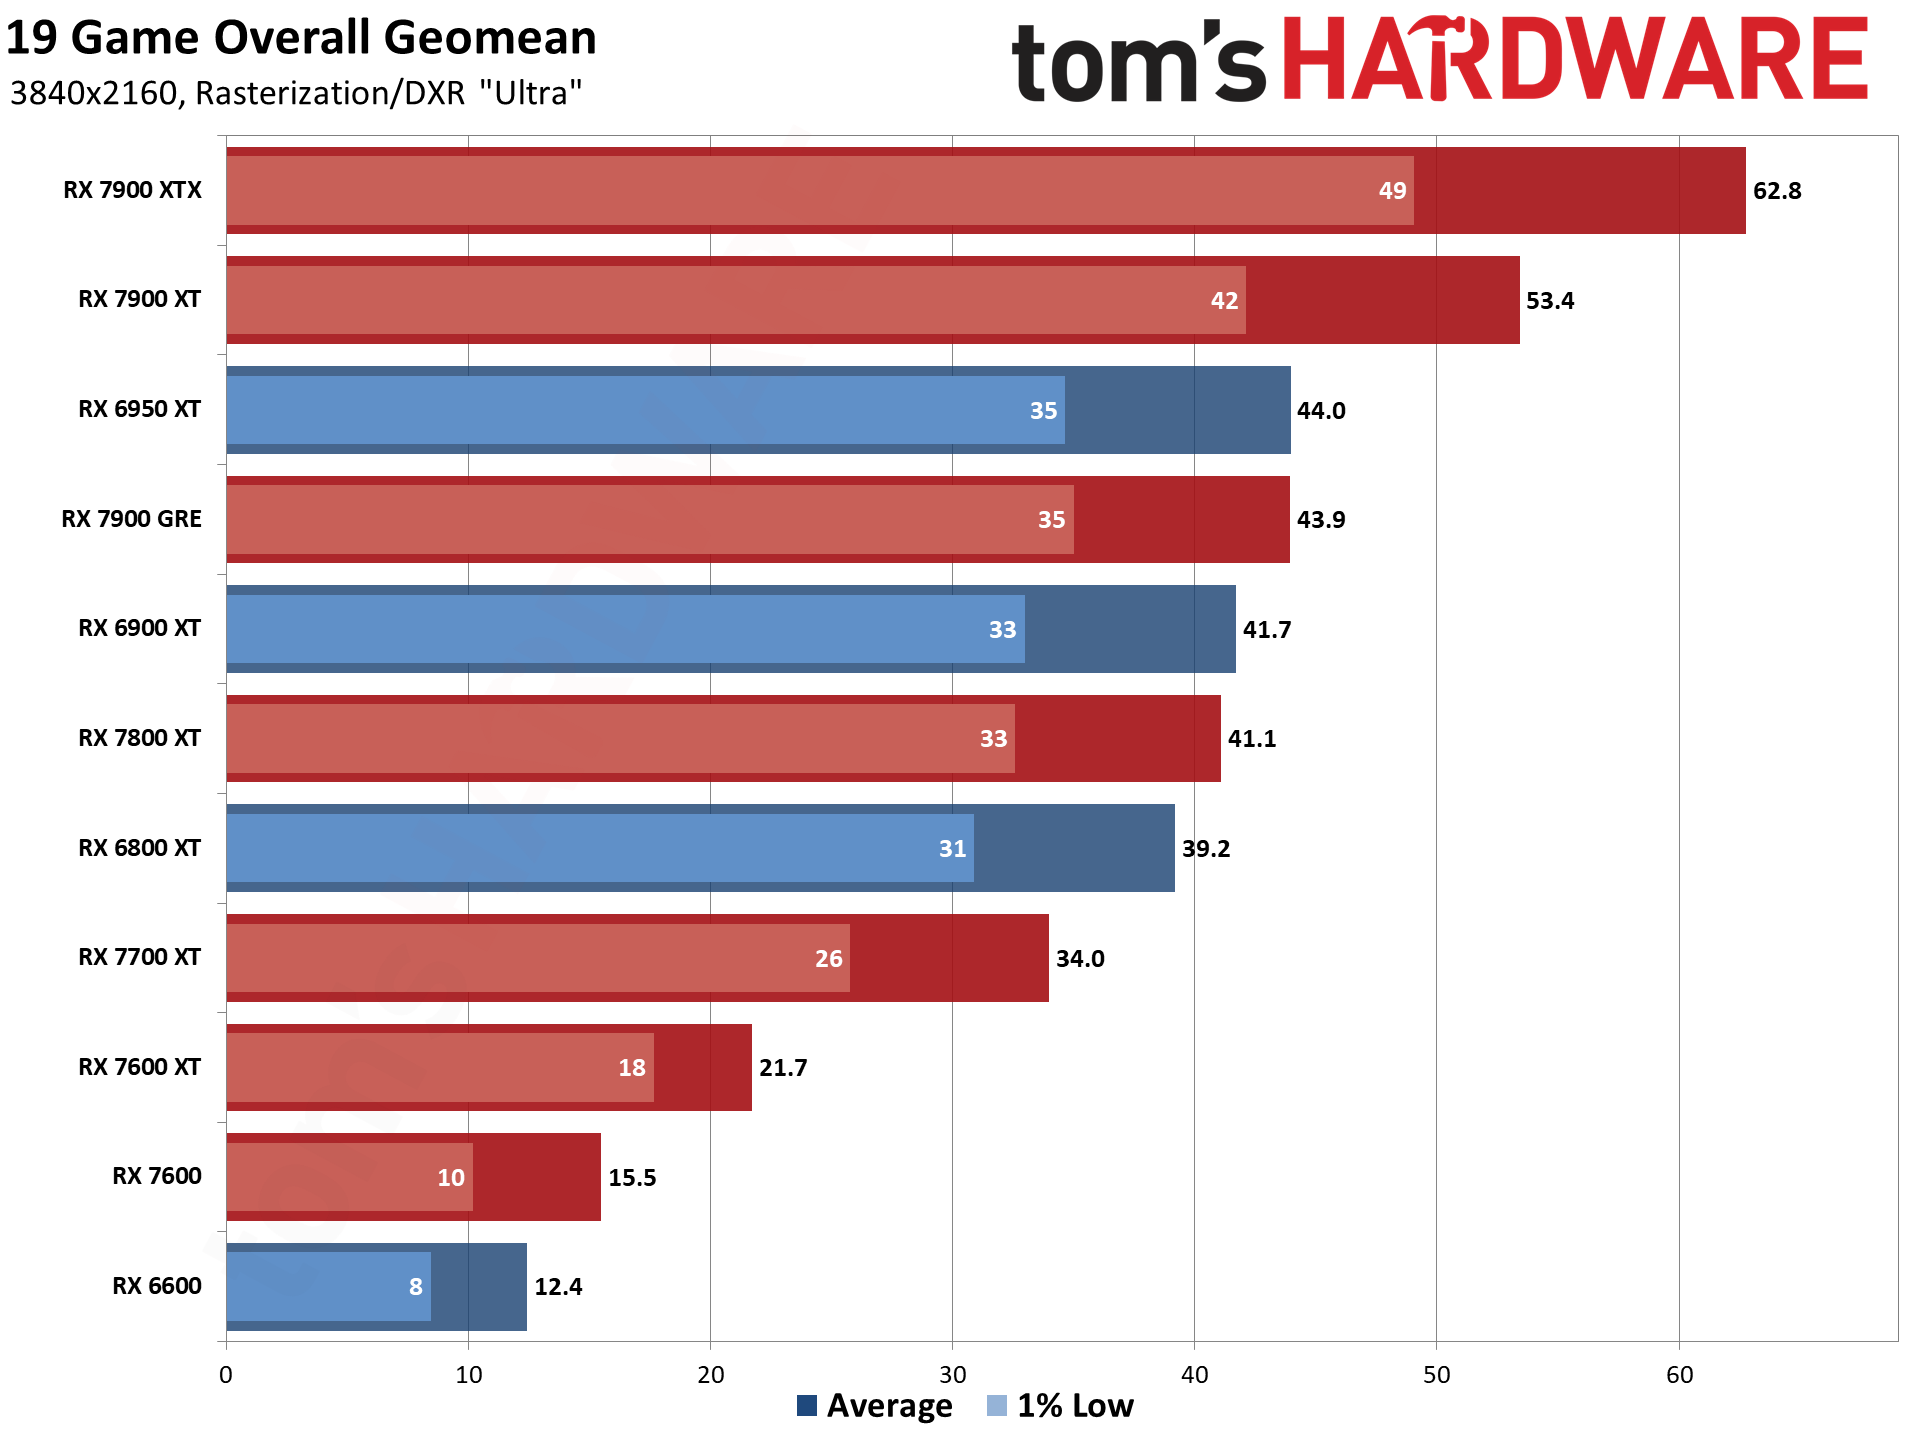
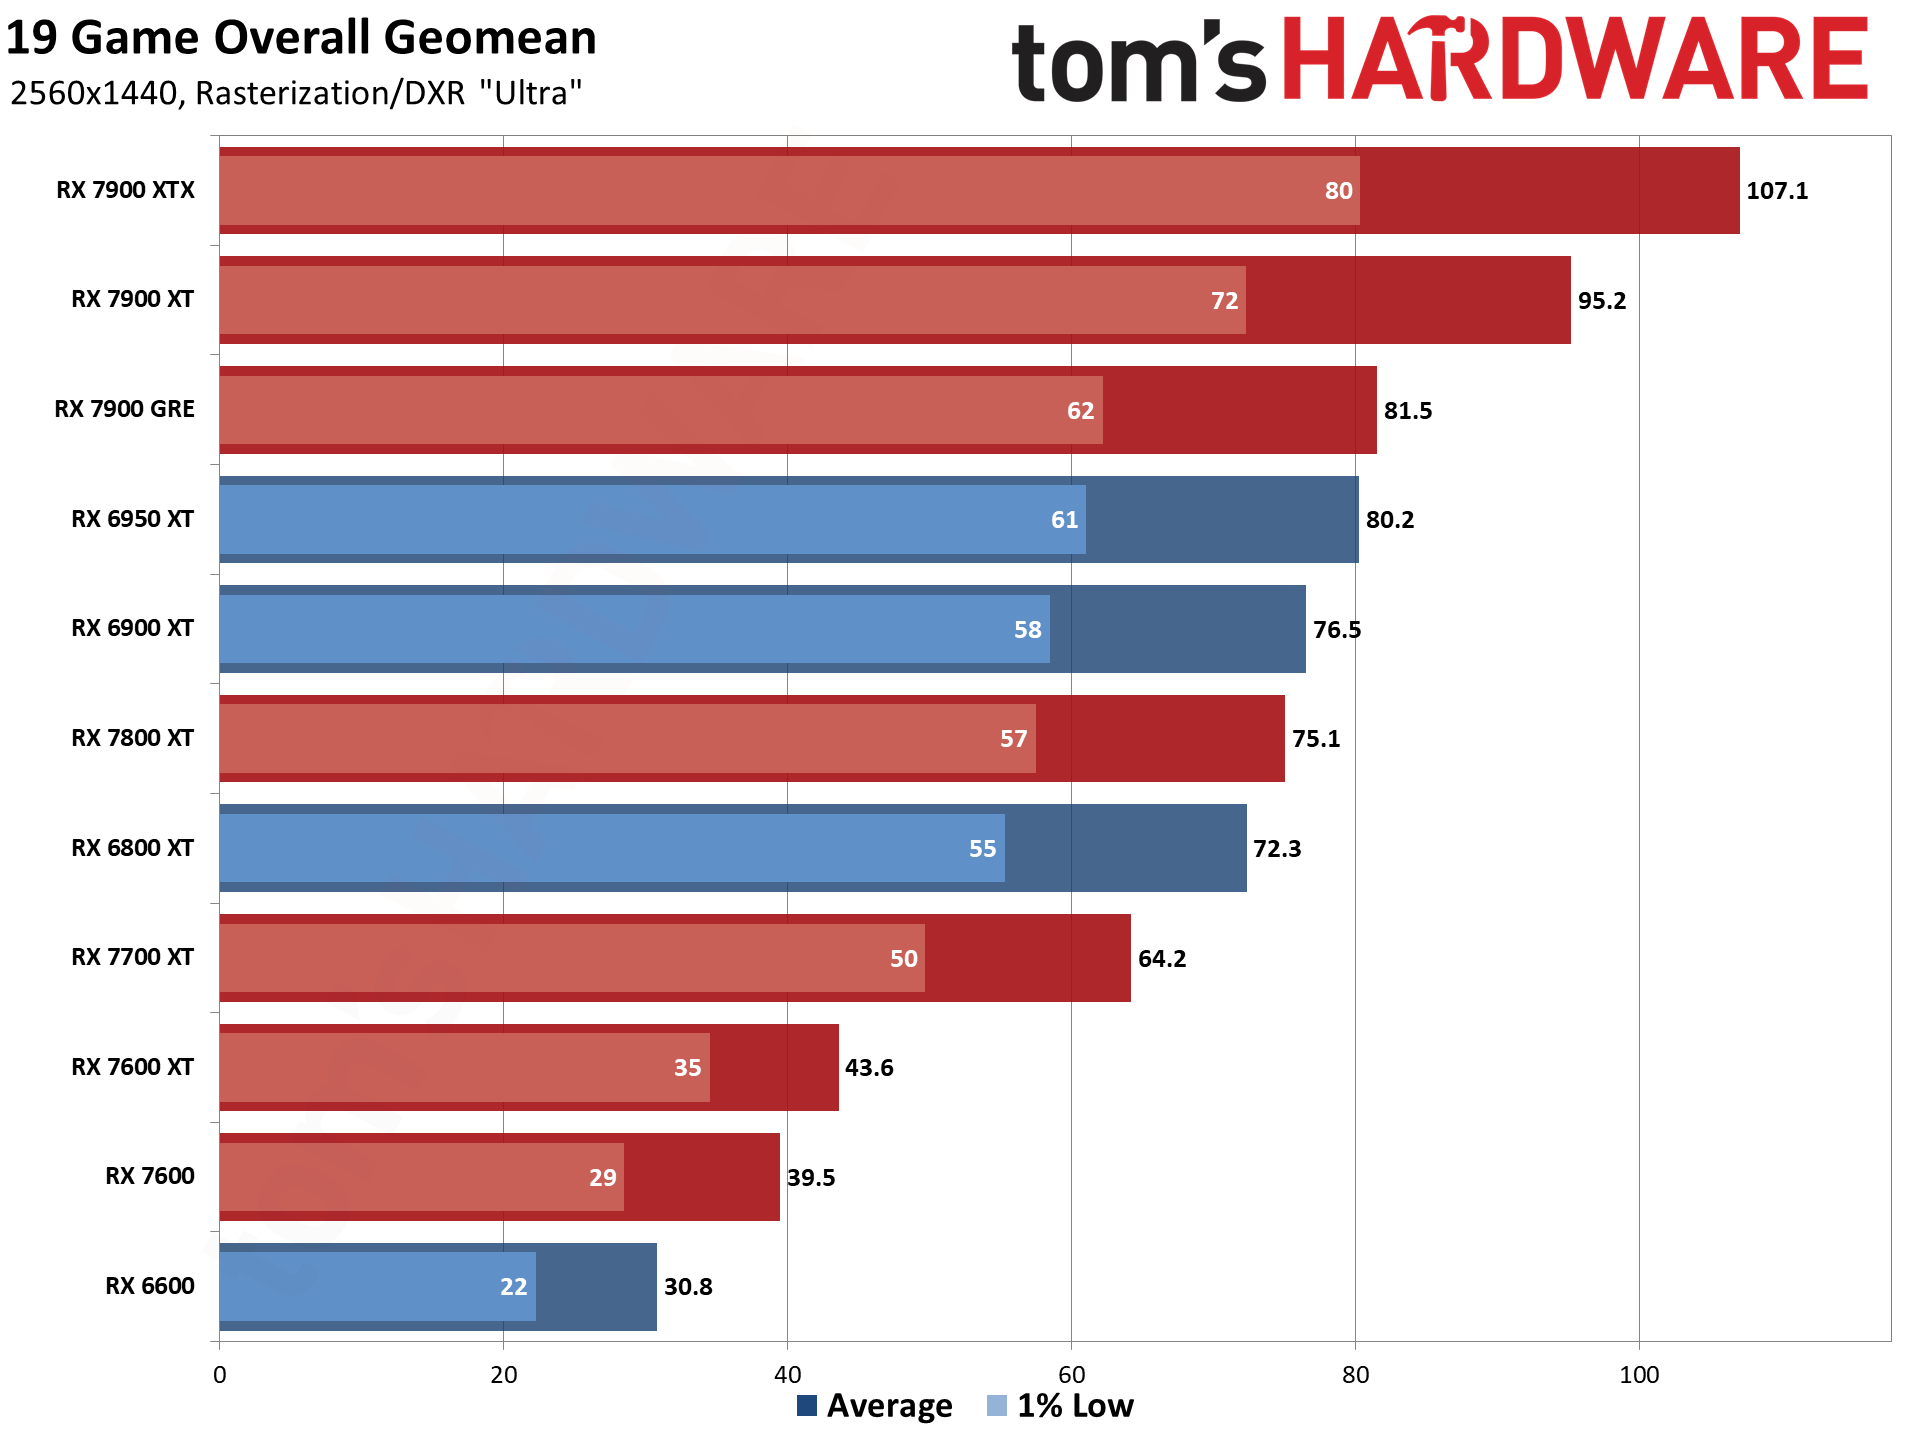
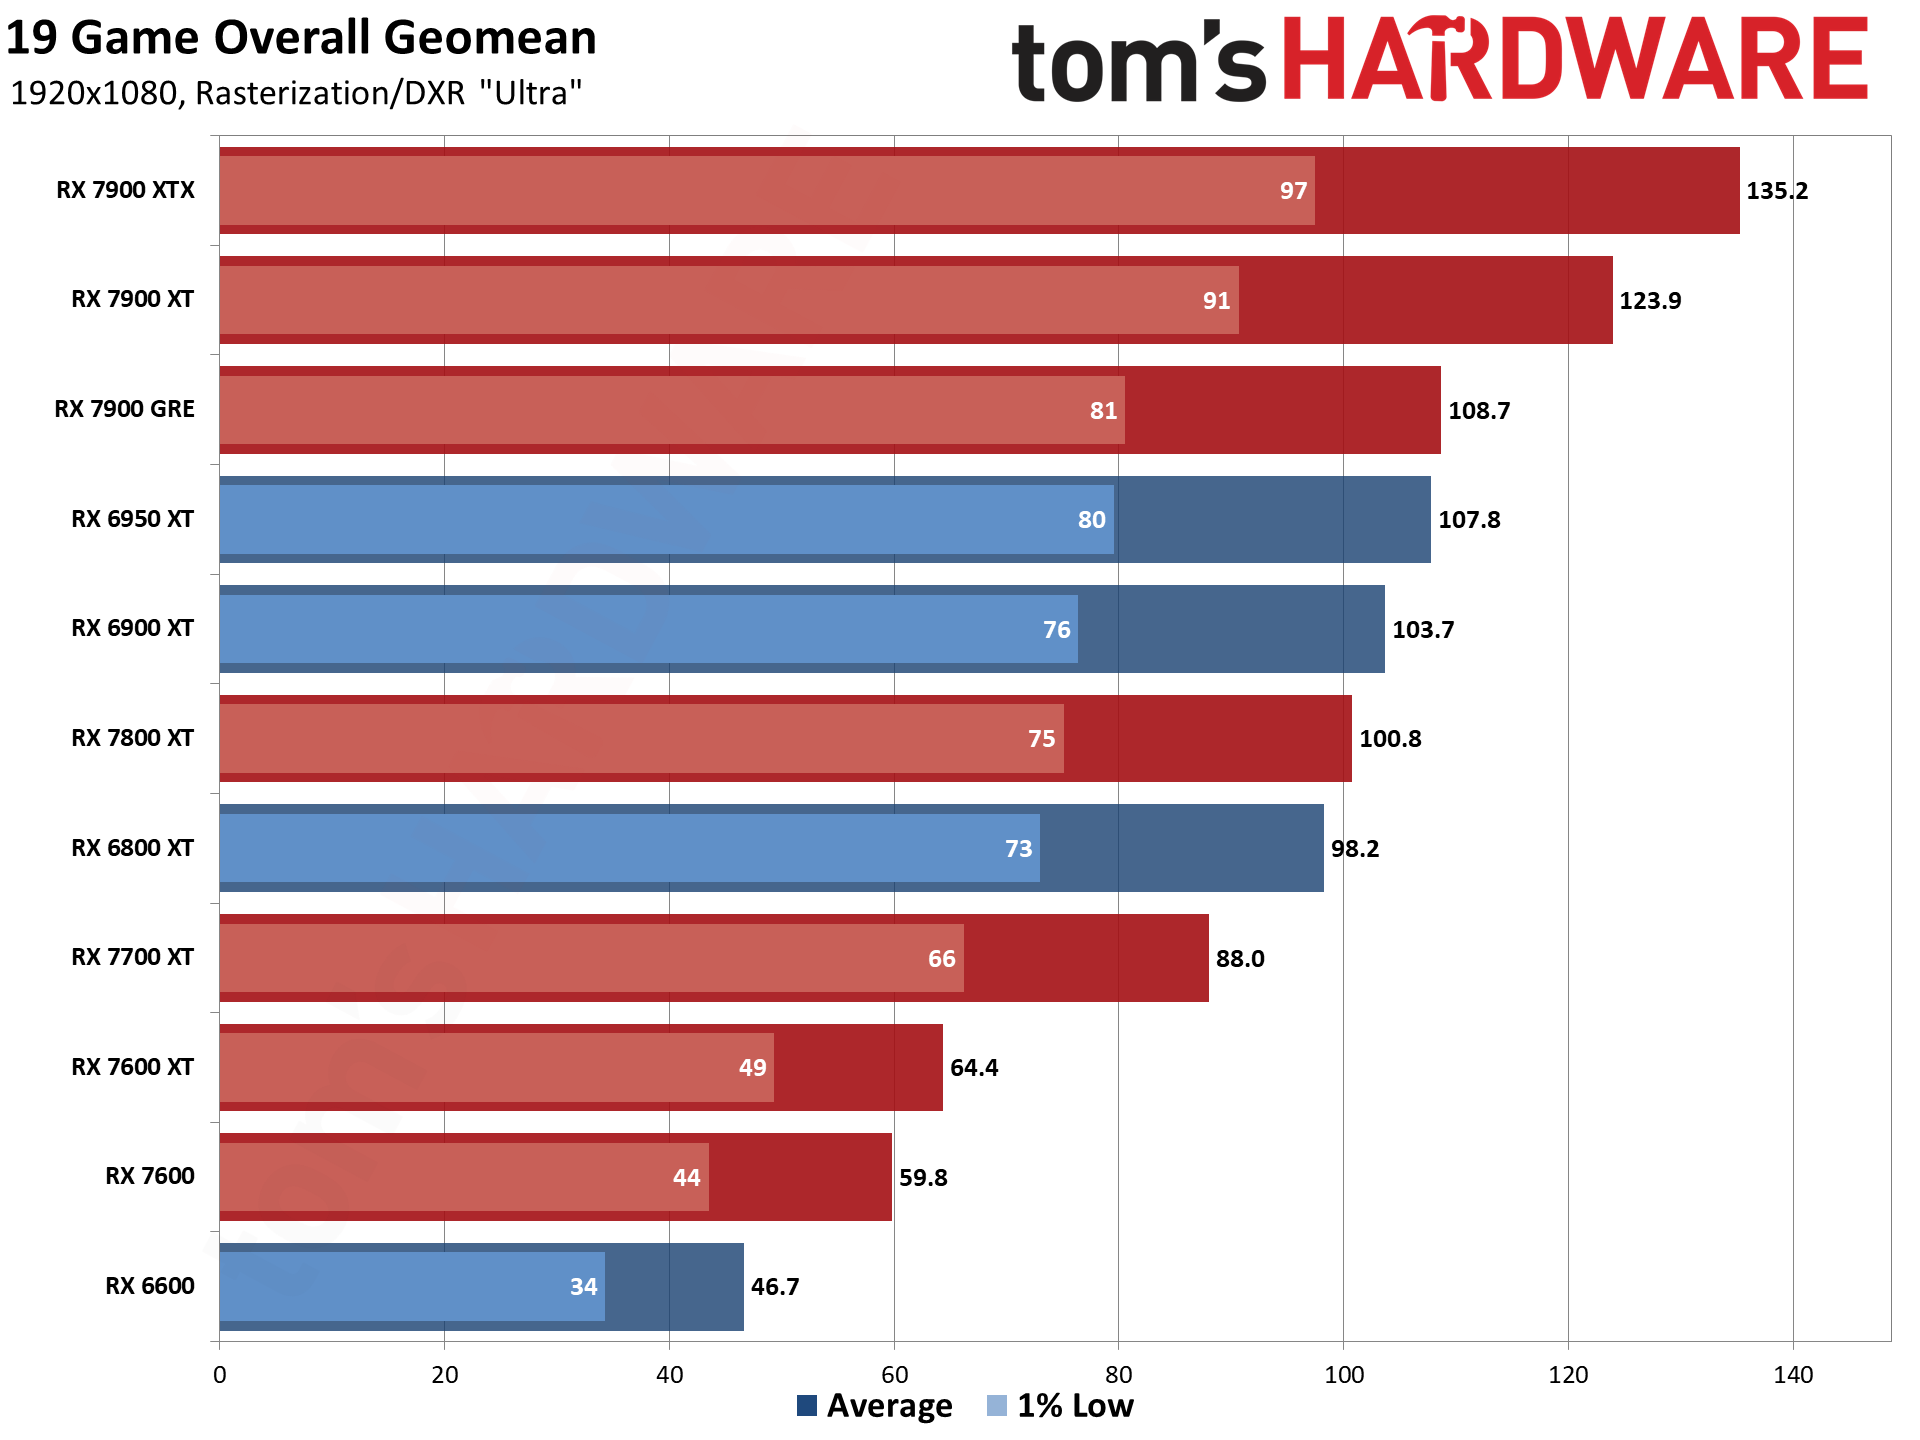
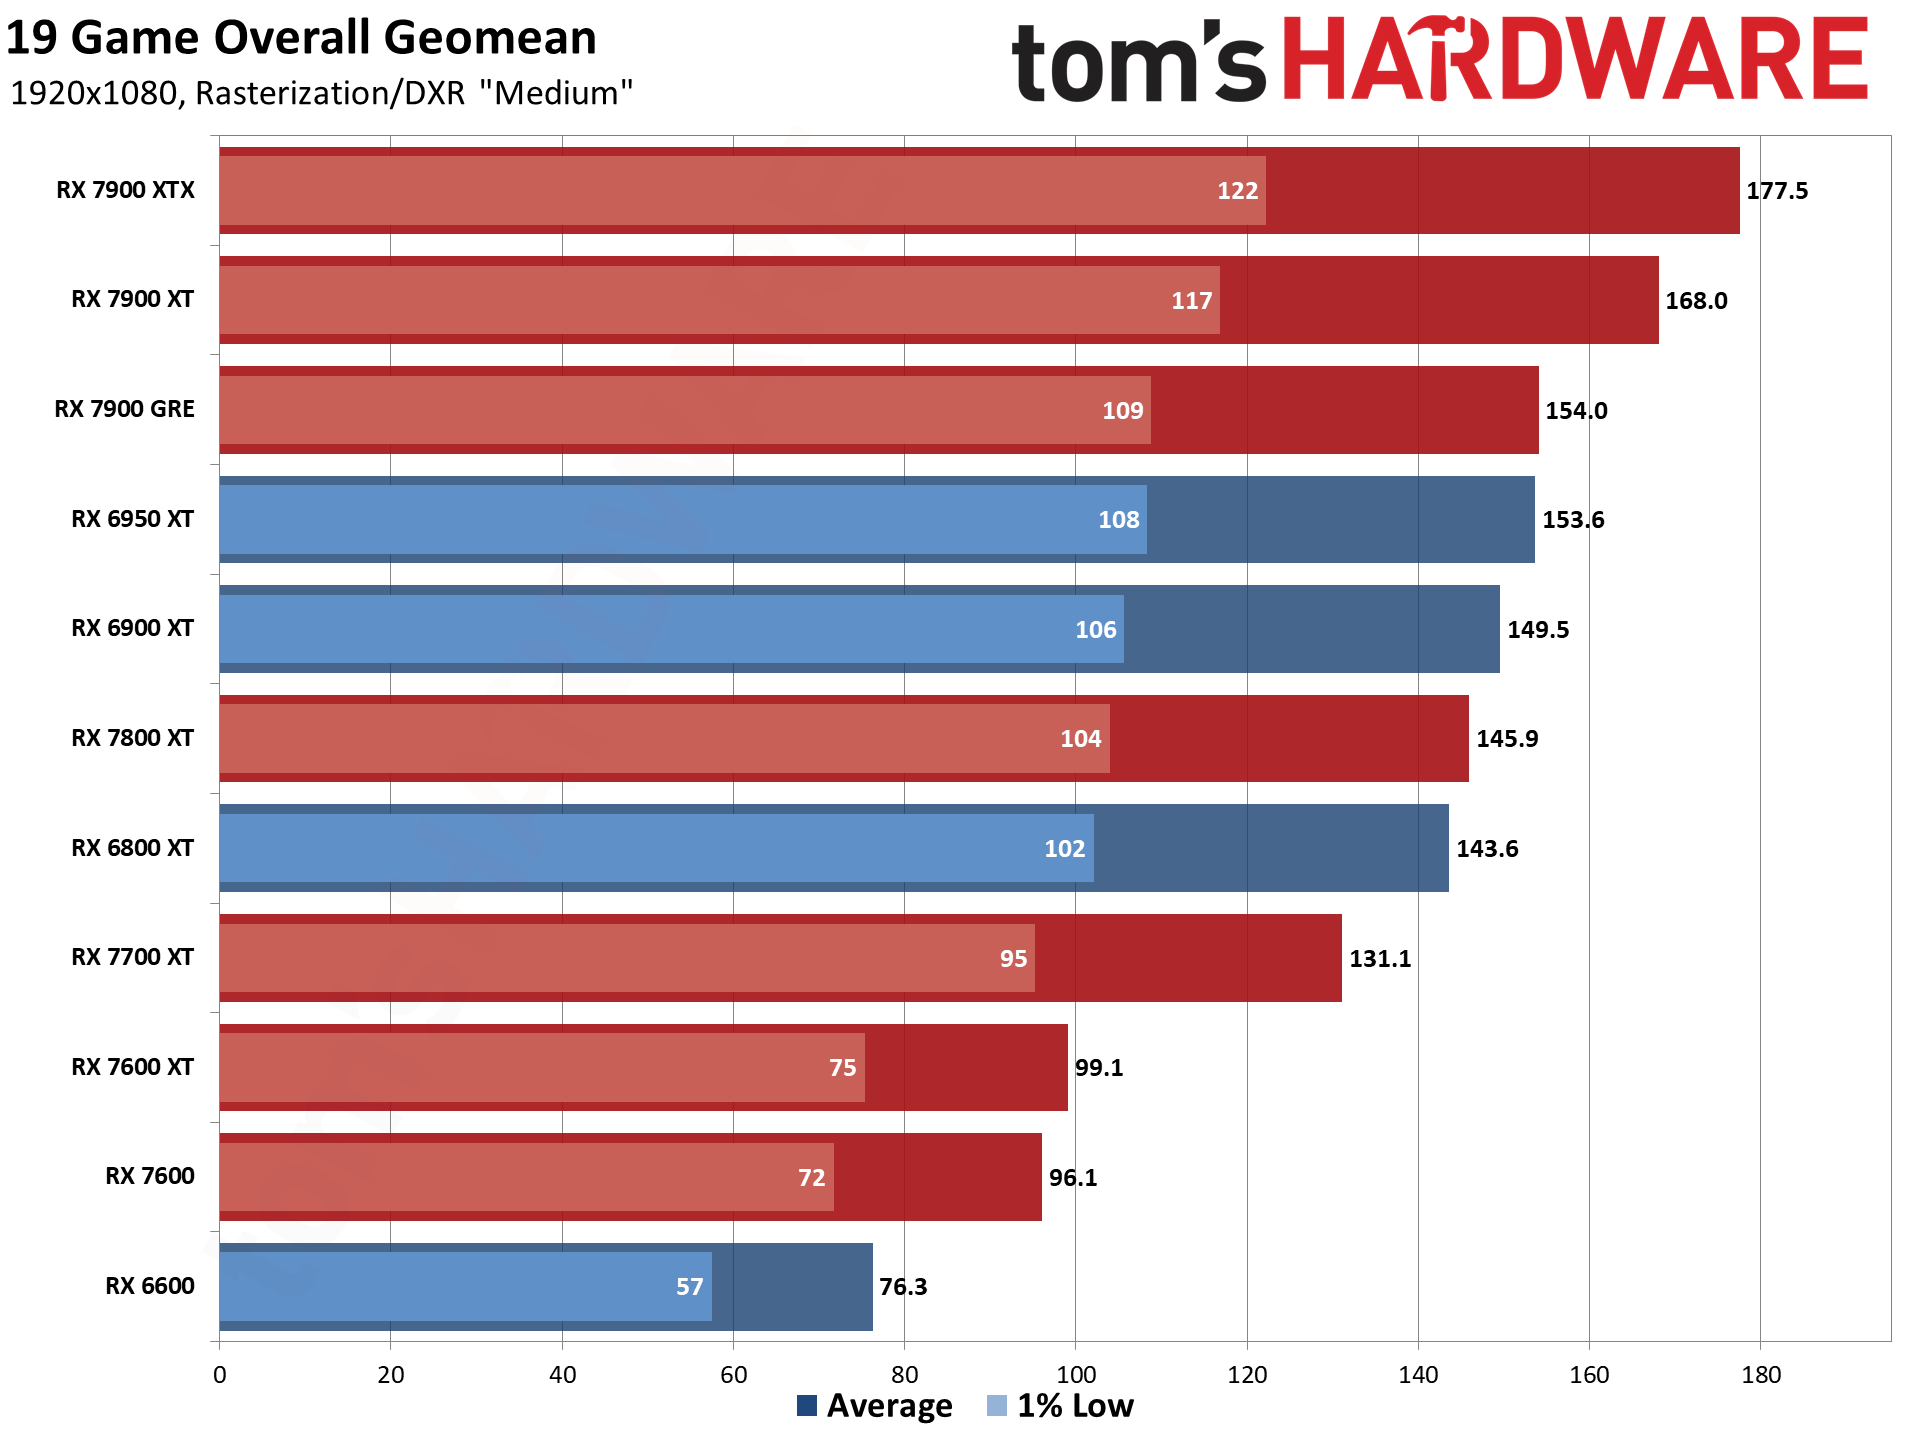
Agora que todas as GPUs RDNA 3 foram lançadas, podemos fornecer avaliações independentes de como elas se comparam — tanto em desempenho quanto em desempenho por watt. Os gráficos acima mostram os resultados gerais do nosso conjunto de testes de 19 jogos. Abaixo, temos tabelas dos resultados dos testes individuais. Cerca de metade das GPUs da série 6000 estão “faltando” porque ainda não temos resultados de testes atualizados, mas fornecemos dados suficientes para colocar a série 7000 em contexto.
(Image credit: AMD)
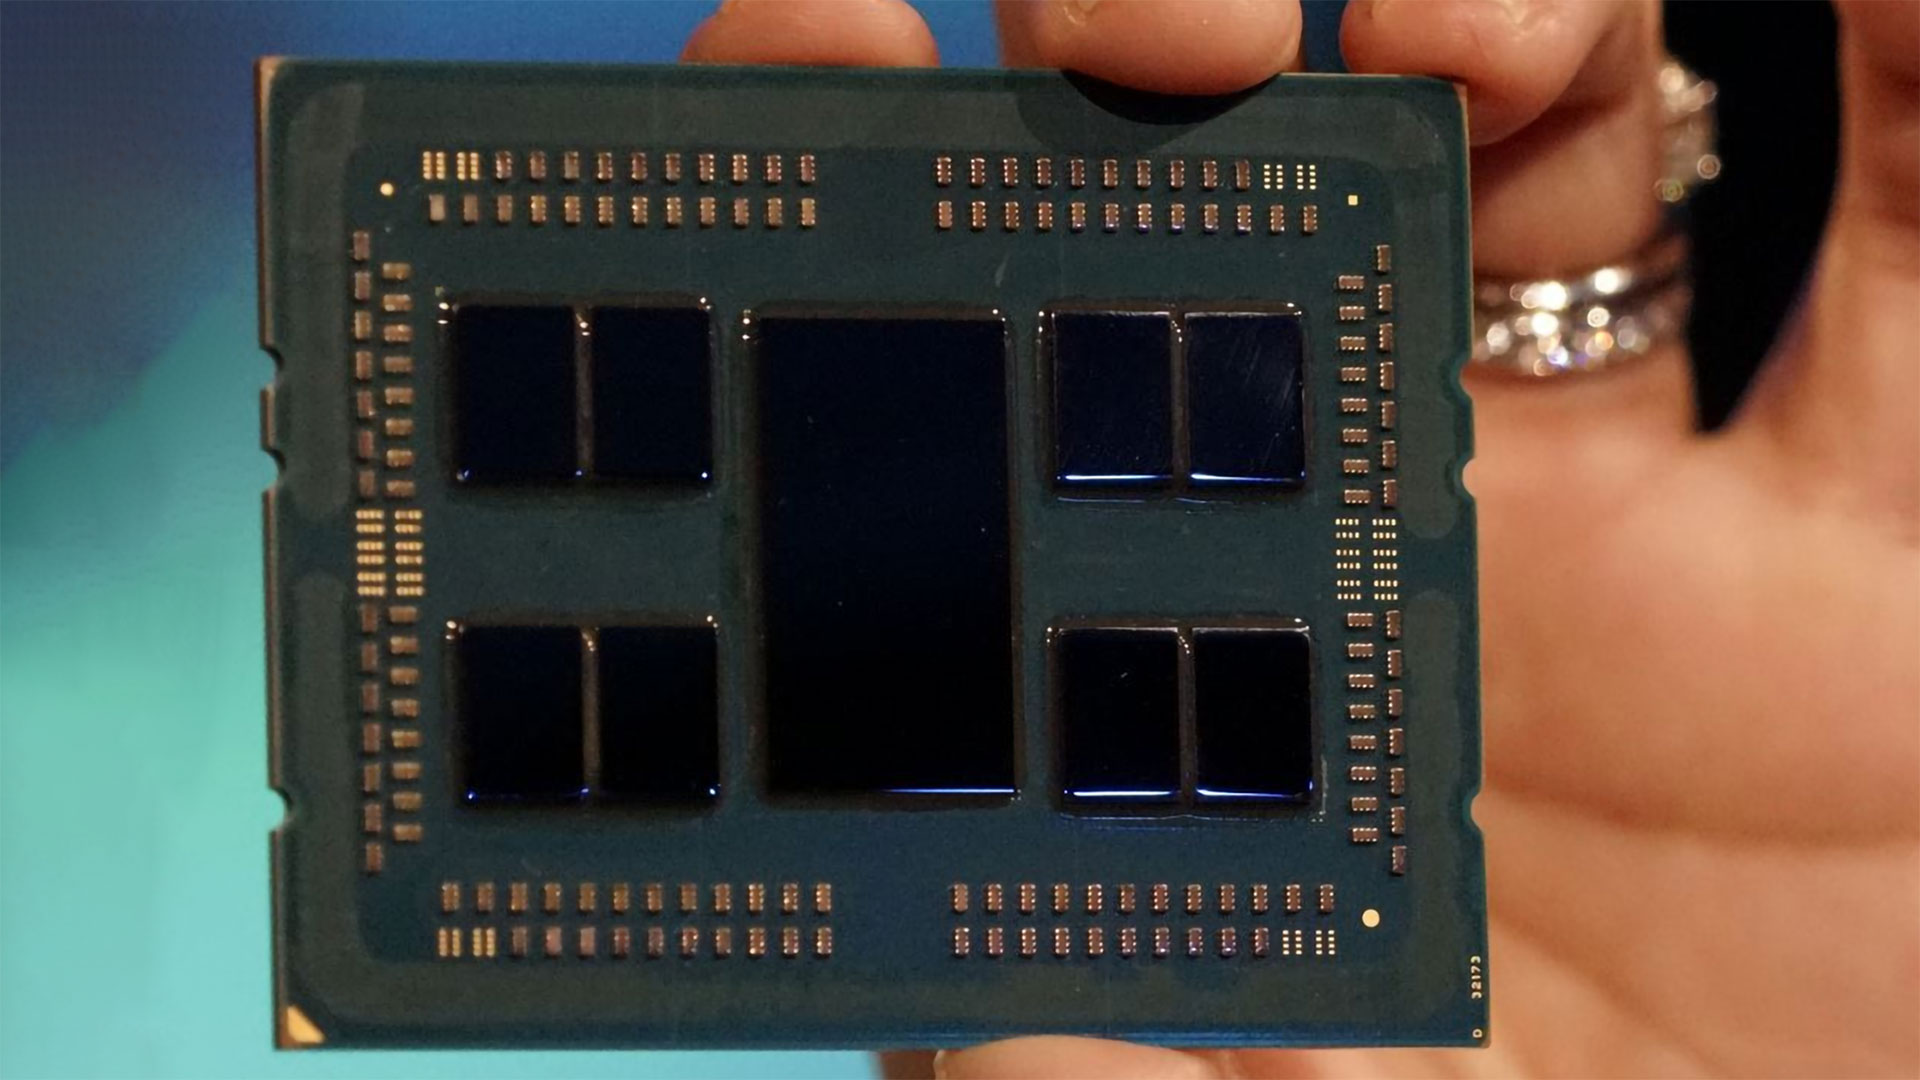
Uma das maiores atualizações arquitetônicas para RDNA 3 é algo que já mencionamos — a mudança para chiplets de GPU. Existem boas razões para mover para múltiplos chiplets, embora o benefício geral dependa em grande parte da implementação. Para esta primeira geração de chiplets de GPU de consumo, a AMD parece estar focada principalmente na redução de custos.
Os designs anteriores de GPU eram monolíticos, o que significa que tudo o que era necessário para o funcionamento da GPU vinha de uma única peça de silício. Por causa disso, as GPUs construíam muita redundância, e os chips eram vendidos em configurações “colhidas”. O Navi 21 foi usado na 6950 XT, 6900 XT, 6800 XT e 6800, com até 80 unidades de computação (CUs) ou apenas 60 CUs.
Curiosamente, o die Navi 21 também tem oito interfaces de memória de 32 bits, mas a AMD não lançou nenhuma variante Navi 21 com menos canais de memória. O mesmo se aplica ao Navi 22, Navi 23 e Navi 24 — os tamanhos de memória e cache parecem ter sido uma coisa de tudo ou nada. Talvez os rendimentos no controlador de memória fossem realmente bons, pois a única GPU que não usava todos os canais de memória possíveis era o Navi 22 na RX 6700 (não-XT), com uma interface de 160 bits em vez da interface completa de 192 bits.
Com Navi 31 e 32, a AMD retirará todos os blocos de interface de memória e Infinity Cache do die principal e os moverá para dies separados. Cada MCD contém uma interface GDDR6 de 64 bits e um bloco de 16MB de Infinity Cache. Havia rumores de que os MCDs tinham a opção de usar empilhamento de chip 3D com outro die de 16MB em cima do MCD principal, mas se esse rumor era verdadeiro, a AMD nunca implementou tal configuração. Os MCDs se conectam ao GCD via Infinity Fabric da AMD, que verá algumas atualizações em relação às variantes anteriores usadas em CPUs Ryzen.
Separar o Infinity Cache e a interface de memória GDDR6 tem algumas vantagens claras. As densidades de transistores escalam melhor com circuitos lógicos, menos com cache e as interfaces analógicas (ou seja, para controladores de memória) escalam pior. As ligações Infinity Fabric no pacote tanto no GCD quanto nos MCDs ainda requerem algum espaço no die, mas quaisquer controladores de memória ou blocos de cache defeituosos não serão mais um problema — eles simplesmente serão descartados.
Enquanto isso, os MCDs serão feitos no processo N6 existente da TSMC, que custa menos do que o nó N5 mais recente, e o tamanho do die não será uma preocupação séria. Os MCDs têm apenas 38mm², o que significa que uma wafer de 300mm N6 deve ter espaço suficiente para cerca de 1.600 MCDs, mais ou menos. Não há dificuldade real em simplesmente descartar todos os chips defeituosos em vez de se preocupar em construir redundâncias.
Os GCDs para Navi 31 e Navi 32, por sua vez, encolhem bastante em comparação com a geração anterior, e no nó N5 mais caro, isso pode ser muito útil. A AMD ainda pode obter cerca de 180 GCDs Navi 31 maiores por wafer ou quase 300 dos Navi 32 menores. E ainda pode usar chips colhidos com menos unidades de computação ou até mesmo MCDs para criar produtos de nível inferior — razão pela qual temos três placas baseadas no GCD Navi 31 e duas usando o GCD Navi 32.
Se a AMD tivesse mantido os designs monolíticos, provavelmente teria acabado com o Navi 31 usando algo mais próximo de 550mm quadrados e obtendo talvez 100 chips por wafer. Como as wafers N5 provavelmente custam mais do que o dobro das N6, isso deve ser uma vitória fácil do ponto de vista de custo. Também dá à AMD mais flexibilidade com tamanhos de cache, pelo menos nos produtos de nível superior. O cache empilhado está apenas nos MCDs, deixando o GCD livre para dissipar calor no sistema de resfriamento — algo com o qual o 3D V-cache teve dificuldades em suas CPUs.
Arquitetura AMD RDNA 3: Melhorias no Núcleo
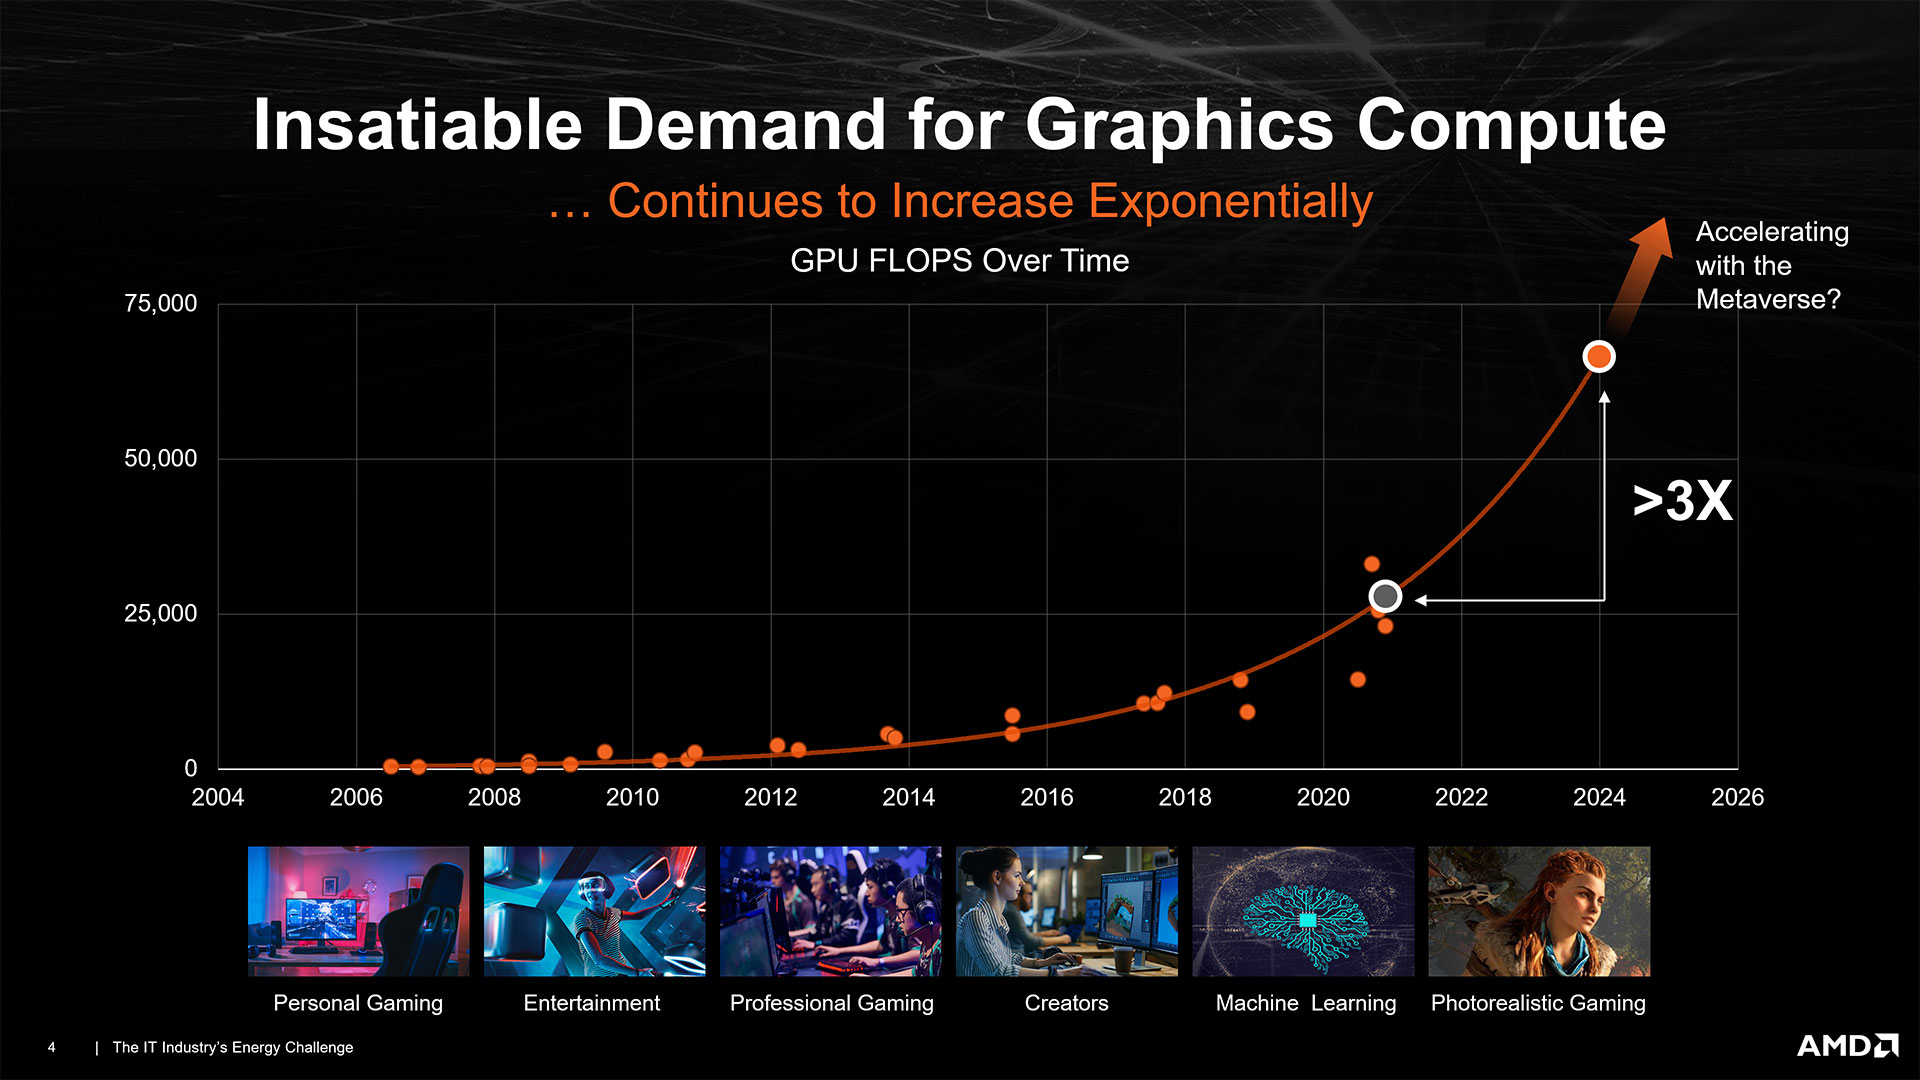
A AMD terá muitas outras mudanças na arquitetura central do RDNA 3. A AMD declarou que terá uma unidade de computação re-arquitetada e uma arquitetura de shader otimizada, embora esta última não forneça muitos detalhes.
As unidades de computação foram reformuladas, e em uma abordagem que se assemelha ao que a Nvidia fez com Ampere, as CUs do RDNA 3 têm o dobro de unidades de execução FP32. Isso gera um grande aumento no cálculo teórico, já que a AMD foi de 80 CUs do RDNA 2 e até 5.120 shaders de GPU para um máximo de 96 CUs do RDNA 3 com 6.144 shaders de GPU que são duas vezes mais poderosos que seus predecessores. Mesmo que o benefício no mundo real