


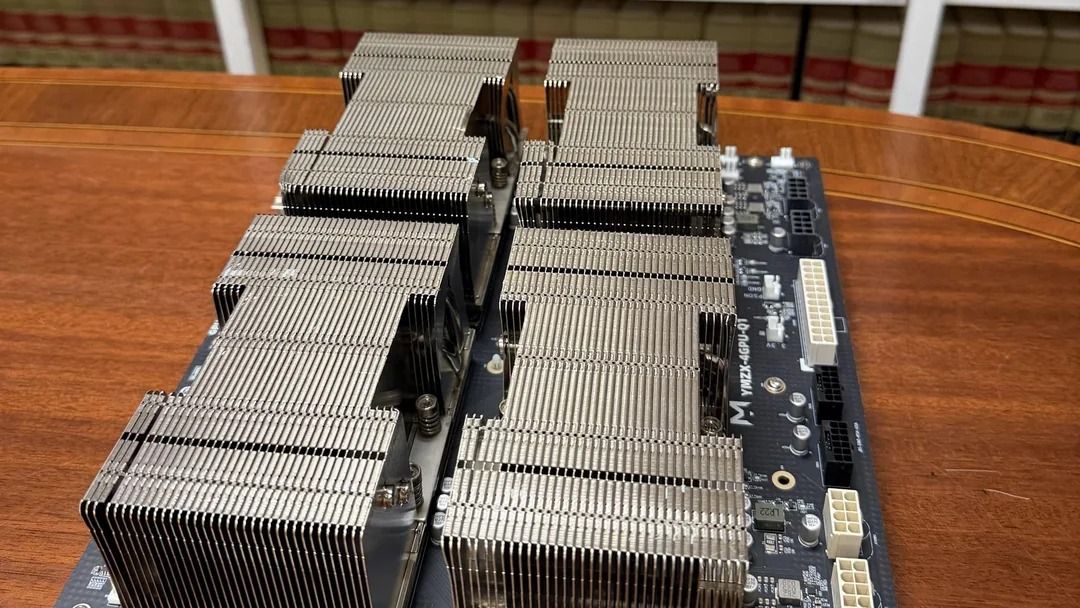
Um advogado resolveu o dilema da privacidade na inteligência artificial montando em casa um servidor de IA privado com oito GPUs Nvidia Tesla V100 usadas, para que os arquivos de seus clientes nunca saiam do escritório.
Segundo reportagem da Tom’s Hardware, o profissional publicou o projeto no Reddit. O sistema usa duas placas-base SXM2 de quatro GPUs com NVLink, quatro switches PEX e cabos SlimSAS, e roda o modelo aberto DeepSeek V4.1 Flash com todos os experts na memória das GPUs, chegando a 215 tokens por segundo.
O hardware por dentro
São oito placas Tesla V100 SXM2 de 32 GB cada, com memória HBM2 de 900 GB/s, encaixadas no soquete SXM2 de data center em vez de slots PCIe. Dentro de cada placa-base, as quatro GPUs se conectam por NVLink, somando 128 GB por placa. As duas placas conversam entre si apenas por PCIe. O restante da máquina é uma placa-mãe Gigabyte com Threadripper Pro 3945WX de 12 núcleos, 8 módulos de 32 GB de DDR4 RDIMM e duas fontes que somam 2.800 W, ligadas em circuitos diferentes do escritório.
De acordo com o Tom’s Hardware, cada placa-base de quatro GPUs custou cerca de US$ 2.400 na compra.
Como o modelo roda
O DeepSeek V4.1 Flash foi comprimido para cerca de 2 bits na maior parte, e seus pesos ainda somam 248,8 GB. Os experts, que fazem o grosso do trabalho a cada palavra, ficam inteiros na memória das GPUs, enquanto cerca de 110 GB de tabelas de consulta, chamadas Engram, ficam na RAM do sistema. Buscar na RAM leva aproximadamente 0,12 milissegundo por passo, o que, segundo o autor, quase não afeta a velocidade.
A primeira metade das camadas roda na primeira placa-base e a segunda metade na outra. Assim, só uma transferência por passo cruza o link PCIe mais lento. Em teste anterior, dividir cada camada entre as oito placas fez a velocidade despencar por causa desse salto.
Quer rodar IA localmente na sua empresa? Veja workstations, GPUs e componentes na GOIG.
Ver hardware na GOIG Pedir orçamento no WhatsApp
Faturamento empresarial em até 90 dias • 12x sem juros no cartão • 10% de desconto no PIX • Nota fiscal para CNPJ • Cupom de primeira compra: BEMVINDOGOIG (5% off)
Desempenho e uso no dia a dia
O servidor é usado diariamente para uma primeira triagem de processos: lê uma pasta de documentos, extrai fatos, datas e valores, resume e faz um primeiro rascunho de peças rotineiras. O autor ressalta que nada sai do escritório sem revisão humana. Há bancos RAG e chamadas de ferramentas integrados, e a operação é feita por uma interface estilo Discord via SSH. Por ora, atende uma requisição por vez. O código é o mais rápido, com até 215 tokens por segundo.
O ponto sobre preço e disponibilidade
Os valores citados já ficaram para trás. Placas V100 SXM2 de 32 GB aparecem no eBay por cerca de US$ 900, mais que o dobro dos aproximadamente US$ 400 por unidade pagos no projeto, e as ofertas indicam que os preços continuam subindo. Isso mostra que hardware usado de data center pode ser um caminho barato para muita VRAM, mas é um mercado volátil e sem garantia.
Por que a privacidade pesa
Escritórios de advocacia, clínicas, contabilidades e áreas de RH lidam com dados que não podem ir a um modelo de nuvem. Rodar um modelo aberto localmente atende a exigências de confidencialidade e reduz o risco de vazamentos. No Brasil, a LGPD reforça essa preocupação, e muitas empresas já avaliam alternativas on-premises para IA.
- Dados sensíveis permanecem na infraestrutura da empresa.
- Custos previsíveis, sem cobrança por token.
- Controle sobre versões e configurações do modelo.
Riscos de montar algo assim
O projeto exigiu cabos em abundância e, segundo o relato, um conector de energia queimado. Consumo elevado, ruído, calor, falta de suporte e ausência de garantia em peças usadas são riscos reais. Para empresas, o caminho mais seguro costuma ser uma estação de trabalho ou servidor homologado, com garantia, suporte e peças de reposição.
O que empresas brasileiras podem aproveitar
Nem toda empresa precisa de oito GPUs. Dependendo da carga, uma workstation com uma ou duas placas de vídeo modernas, bastante RAM e armazenamento rápido atende resumos, classificação e busca em documentos. O importante é dimensionar o hardware para o modelo e para o número de usuários simultâneos, e planejar refrigeração, energia e nobreak.
Precisa dimensionar um servidor ou workstation para IA? Peça um orçamento especializado.
Ver hardware na GOIG Pedir orçamento no WhatsApp
Faturamento empresarial em até 90 dias • 12x sem juros no cartão • 10% de desconto no PIX • Nota fiscal para CNPJ • Cupom de primeira compra: BEMVINDOGOIG (5% off)
Perguntas frequentes
Quantas GPUs tem o servidor do advogado?
Oito Nvidia Tesla V100 SXM2 de 32 GB, em duas placas-base de quatro GPUs.
Qual modelo de IA ele roda?
O DeepSeek V4.1 Flash, comprimido para cerca de 2 bits, com 248,8 GB de pesos.
Qual a velocidade?
Até 215 tokens por segundo em código, atendendo uma requisição por vez.
Por que usar IA local?
Para manter arquivos confidenciais de clientes fora de modelos de nuvem.
Fonte original: Tom’s Hardware. Texto reescrito e contextualizado pela equipe GOIG.