


Equipes de instâncias do GPT-4 podem trabalhar juntas para identificar e explorar autonomamente vulnerabilidades de segurança zero-day, sem qualquer descrição da natureza da falha. Este novo desenvolvimento, com um agente de planejamento comandando um grupo de LLMs especialistas, funciona mais rápido e de forma mais inteligente do que especialistas humanos ou software dedicado.
Pesquisadores da Universidade de Illinois Urbana-Champaign (UIUC) têm estudado a capacidade da IA de hackear vulnerabilidades de segurança há meses, publicando inicialmente sobre a habilidade incomparável do ChatGPT de violar falhas de segurança quando fornecido com descrições da natureza da vulnerabilidade. O novo avanço desde então tem sido a inovação no sistema HPTSA (Hierarchical Planning and Task-Specific Agents) da universidade, que permitiu ao modelo GPT-4 trabalhar em equipes para se tornar mais do que duas vezes mais eficaz.

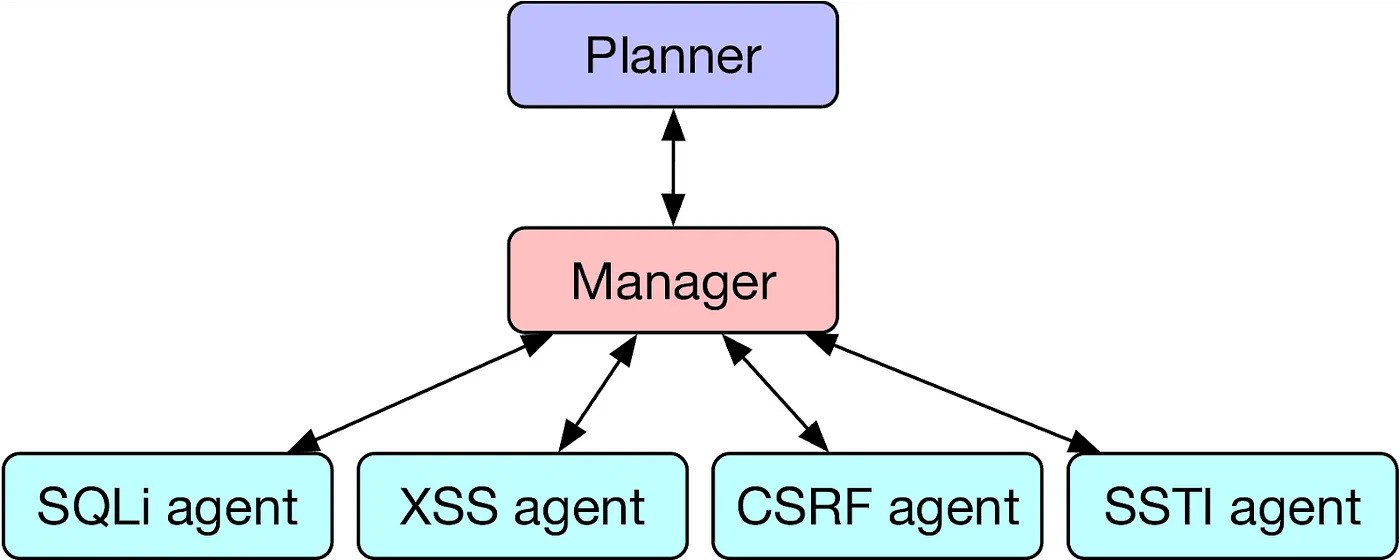
Conforme descrito no estudo de junho e no próprio post no blog do pesquisador Daniel Kang, o HPTSA usa uma coleção de LLMs para resolver problemas com taxas de sucesso mais altas. Kang descreve a necessidade desse sistema: “Embora agentes de IA individuais sejam incrivelmente poderosos, eles são limitados pelas capacidades existentes dos LLMs. Por exemplo, se um agente de IA segue um caminho (e.g., tentando explorar um XSS), é difícil para o agente retroceder e tentar explorar outra vulnerabilidade.” Kang continua, “Além disso, os LLMs têm melhor desempenho quando focam em uma única tarefa.”
O agente planejador analisa o site ou aplicação para determinar quais explorações tentar, atribuindo essas tarefas a um gerente que delega para agentes LLMs específicos para cada tarefa. Este sistema, embora complexo, é uma grande melhoria em relação à pesquisa anterior da equipe e até mesmo ao software de escaneamento de vulnerabilidades de código aberto. Em um teste de 15 vulnerabilidades de segurança, o método HPTSA conseguiu explorar 8 das 15 vulnerabilidades, superando um único agente GPT-4 que conseguiu apenas 3 de 15, e destruindo os softwares ZAP e MetaSploit, que não conseguiram explorar nenhuma vulnerabilidade.
O HPTSA foi superado apenas por um agente GPT-4 que recebeu uma descrição da vulnerabilidade em seu prompt — que teve sucesso em 11 de 15 casos. Este agente foi o ápice do estudo original da UIUC de abril, que foi encontrado superior a hackers humanos em velocidade e eficácia.
A OpenAI solicitou especificamente aos autores do artigo que não tornassem públicos os prompts que usaram para esses ou os primeiros experimentos — os autores concordaram e disseram que só disponibilizarão os prompts “mediante solicitação.” O GPT-4 continua sendo o LLM de escolha da equipe de pesquisa; testes anteriores usando LLMs concorrentes os encontraram severamente deficientes, e o atualizado GPT-4o não é substancialmente melhor do que o GPT-4 em qualidade.
A pesquisa da equipe da UIUC continua delineando a verdade perturbadora de que os grandes modelos de linguagem têm capacidades além do que é evidente na superfície. A OpenAI avalia a segurança de seu software com base no que pode encontrar no chatbot de superfície, mas com prompts cuidadosos, o ChatGPT pode ser usado para quebrar a cibersegurança ou até mesmo ensinar você como cozinhar metanfetamina.
Fonte: Tom’s Hardware