


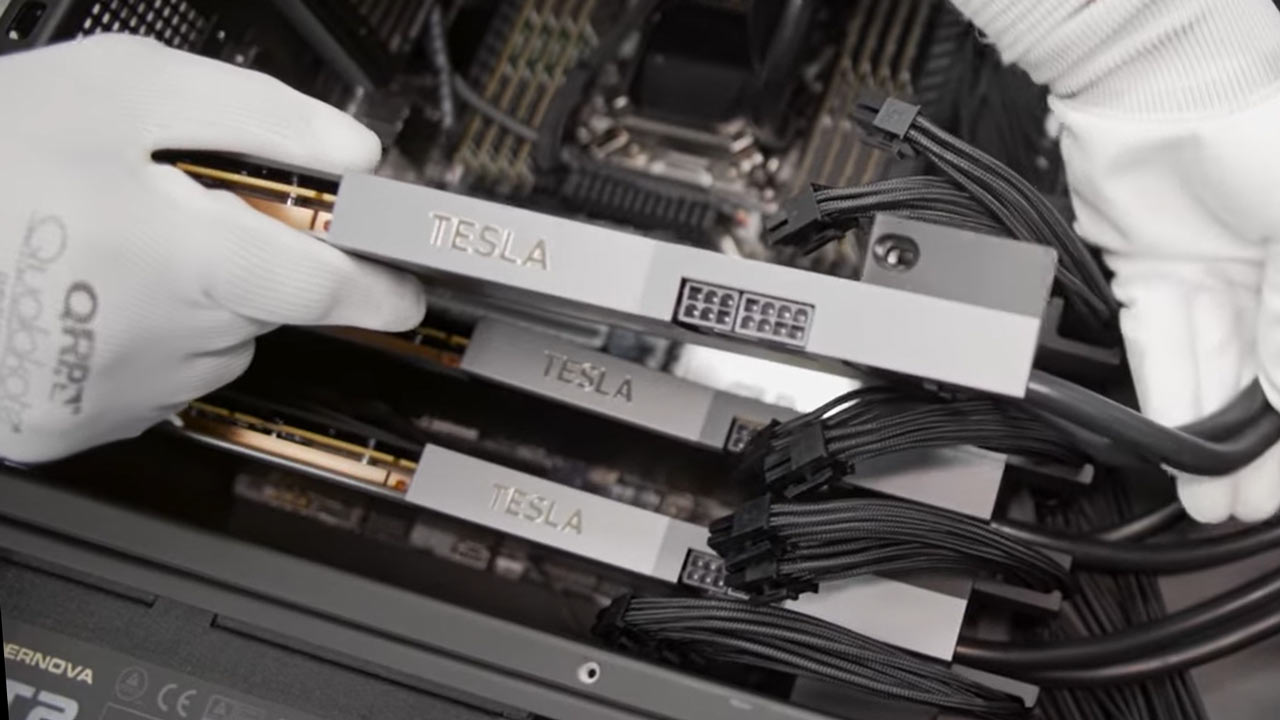
Um engenheiro que trabalhou no Twitter durante a transição sísmica Agrawal-Musk relembrou publicamente sobre encontrar um cluster de 700 GPUs Nvidia V100. Tim Zaman, que agora trabalha como engenheiro de software no Google DeepMind, descobriu essa quantidade significativa de poder de GPU ligado, mas ocioso, no data center do ancestral do X.
A few weeks post Twitter-acquisition in 2022 we found 700 V100 gpus (pcie, lol) in the datacenter.They were powered on and idle, and had been for ages: the forgotten remains of a honest attempt to make a cluster within Twitter 1.0.Haha how times have changed! 100k gpus on the… July 22, 2024
A massa quente e zumbidora de silício e PCBs da Nvidia no data center do Twitter foi poeticamente descrita como “os restos esquecidos de uma tentativa honesta de fazer um cluster dentro do Twitter 1.0” por Zaman em um post no Twitter/X na segunda-feira. O engenheiro foi motivado a escrever sobre sua surpreendente descoberta desse tesouro de silício após ler sobre o Memphis Supercluster do xAI começando a trabalhar no treinamento do Grok 3, alimentado por 100.000 aceleradores Nvidia H100 refrigerados a líquido em uma única malha RDMA.
Zaman destacou o que muitos de vocês estarão pensando – o Twitter tinha 700 das GPUs mais poderosas do mundo funcionando sem propósito por anos. “Como os tempos mudaram!” exclamou. De fato, as primeiras GPUs V100 da arquitetura Volta da Nvidia para data centers começaram a chegar ao mercado durante a primeira grande escassez de GPUs em 2017, e Zaman encontrou o cluster alimentado por 700 placas V100 funcionando sem propósito em meados de 2022. Isso é muito tempo de computação e recursos desperdiçados.
Outro momento de diversão para Zaman foi descobrir que as 700 Nvidia V100s eram GPUs PCIe, em vez da variedade de fator de forma SXM2 com interface NVLink de largura de banda muito maior. Claro, não sabemos por que o Twitter da era de 2017 comprou GPUs V100 PCIe em vez de bus SXM2 para essa instalação considerável, e talvez nunca saibamos.
O tweet de Zaman também continha algumas reflexões interessantes sobre a nova ‘Gigafactory of Compute’ de Musk. Executar “100k GPUs na mesma malha deve ser um desafio épico”, comentou o engenheiro. “Nessa escala, a única garantia é o fracasso, e tudo se resume a uma gestão graciosa do fracasso.” Com isso em mente, Zaman ponderou sobre desagregar recursos em domínios distintos para que falhas não derrubassem toda a casa.
O engenheiro também achou fascinante o número máximo potencial de GPUs que poderiam existir em uma única malha. Com os titãs da tecnologia correndo para construir clusters de treinamento de IA cada vez maiores, tanto limites previsíveis quanto imprevistos sobre o número máximo de GPUs na mesma fibra estão destinados a se tornar conhecidos.
Fonte: Tom’s Hardware