


Entrevistamos Mike Clark, Engenheiro de Design de Silício Corporativo da AMD, durante o recente Tech Day da empresa, onde foi revelada a microarquitetura Zen 5 que alimenta os processadores Ryzen 9000 e Ryzen AI 300 da empresa.
Clark, conhecido como o “Pai do Zen” ou, dependendo do funcionário da AMD com quem você fala, o “Zen Daddy”, trabalha nas arquiteturas de CPU da AMD há 31 anos. Ele foi o arquiteto líder da primeira geração do Zen, que ele revelou no Hot Chips enquanto a empresa estava à beira da falência em 2016.
Nos últimos sete anos, a AMD revelou cinco gerações do Zen, cada uma entregando aumentos de dois dígitos na melhoria das instruções por clock (IPC). Clark liderou o desenvolvimento do Zen em todas as cinco gerações, com uma sexta em andamento, transformando a AMD de um fabricante de chips em dificuldades para uma queridinha do mercado de ações que agora recuperou uma quantidade significativa de participação de mercado da Intel. Agora, a AMD tem quase o dobro do valor de mercado de sua antiga rival Intel, e as arquiteturas impulsionadas por Clark serviram como combustível para essa incrível reviravolta.

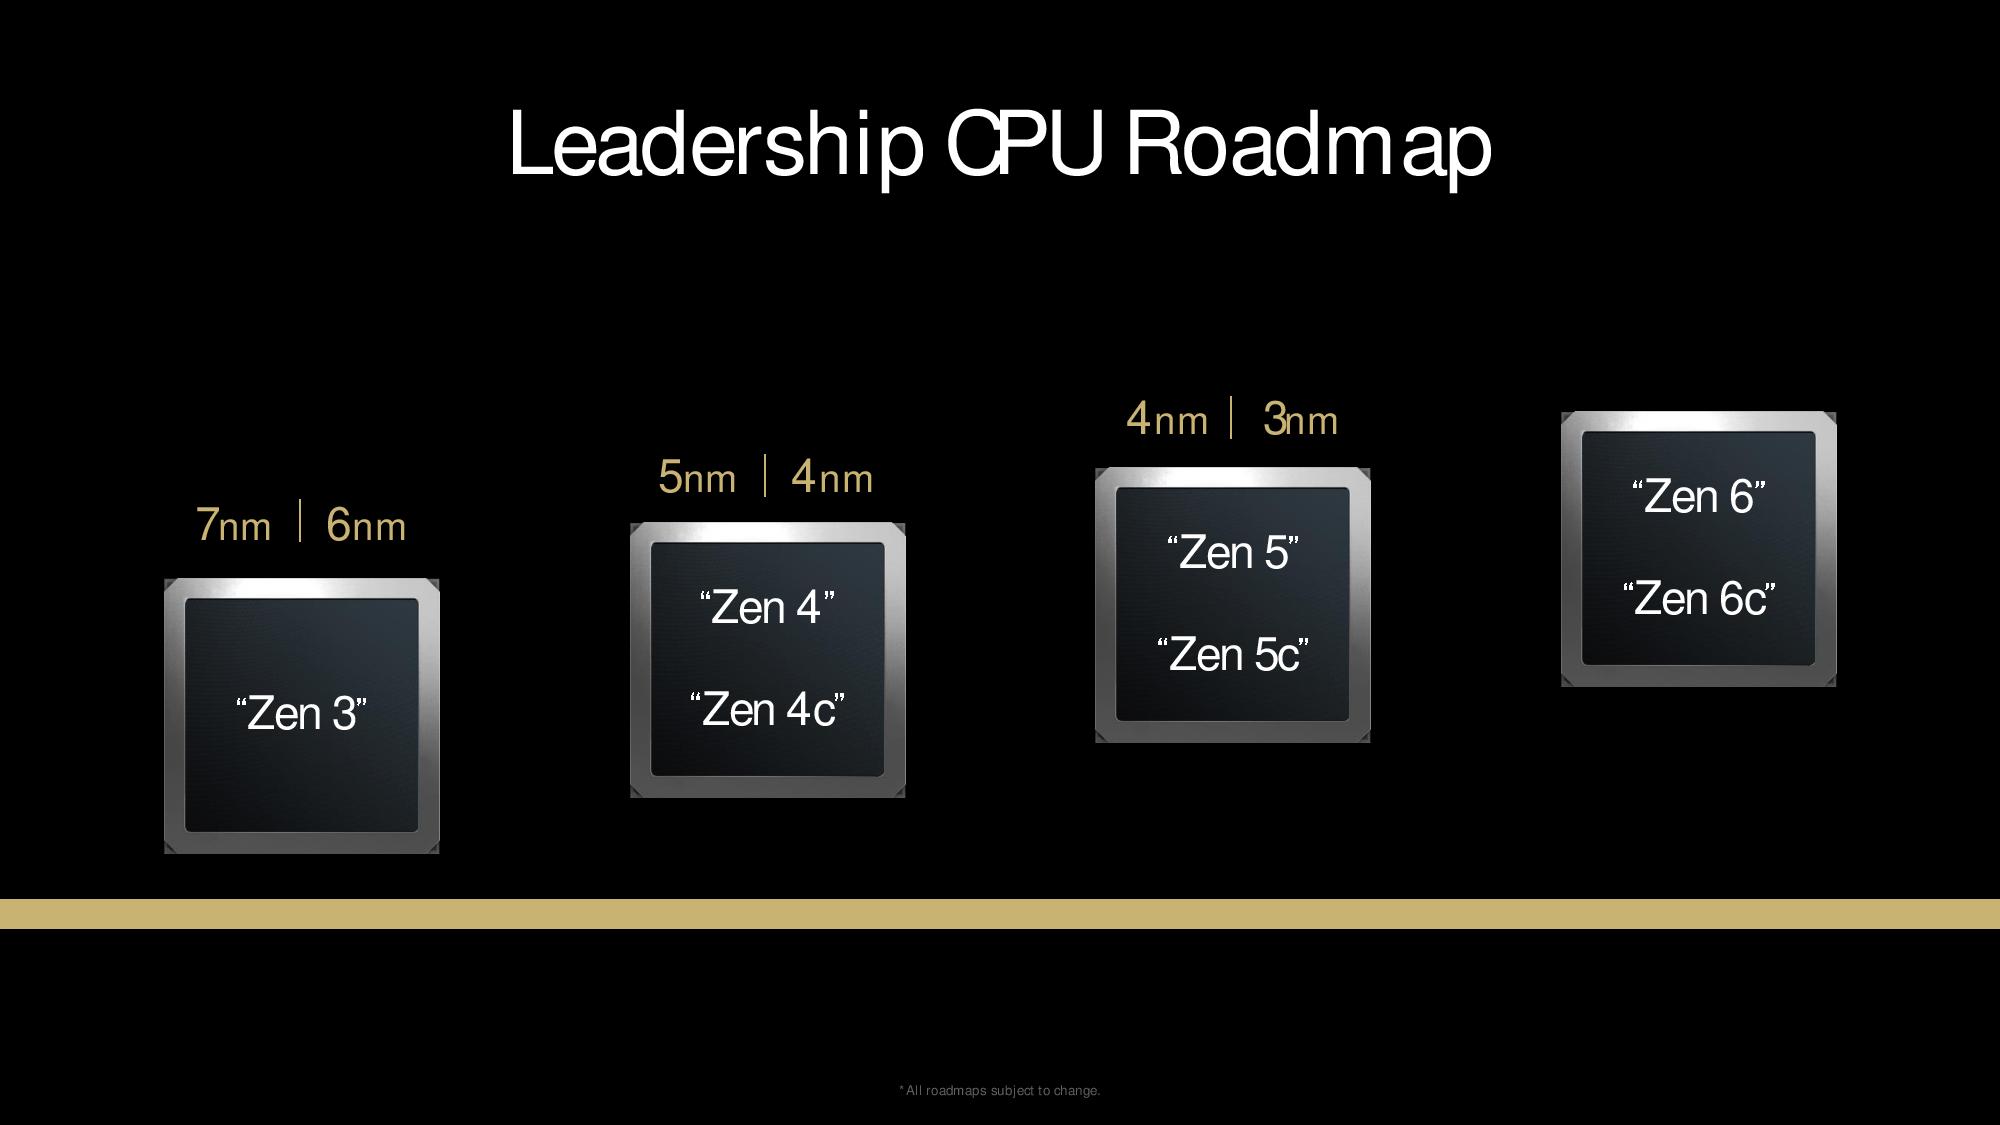
A arquitetura Zen 5 da AMD abrangerá os nós de processo de 4nm e 3nm, alimentando a próxima geração de toda a linha de produtos de CPU da AMD, desde PCs desktop e móveis até seus processadores EPYC para data centers. Projetar uma arquitetura subjacente coesa para atender a todos esses mercados é uma façanha de engenharia incrível. A AMD lançará os chips Zen 5 de 4nm no final deste mês, mas ainda não anunciou o cronograma para as variantes de 3nm. Clark expandiu sobre os desafios de projetar o Zen 5 para os processos de 4nm e 3nm simultaneamente, dizendo que as duas versões estão basicamente chegando “uma em cima da outra”.
A AMD usou seus núcleos compactos Zen ‘c’, núcleos menores projetados para tarefas em segundo plano, muito parecidos com os E-cores da Intel, para reduzir custos e aumentar o desempenho em seus processadores de laptop. No entanto, ao contrário de sua concorrente, a AMD ainda não trouxe esses núcleos para sua linha de desktop. O Zen 5c marca a segunda iteração dos núcleos compactos da AMD, mas atualmente não estão planejados para a família Ryzen 9000. No entanto, Clark disse que acredita que os núcleos compactos virão para futuros chips Ryzen desktop e também expandiu as técnicas que a empresa usa para sua implementação única.
A Intel abandonou notoriamente a injeção de suporte de aceleração de hardware para instruções AVX-512 de alto desempenho, mas o Zen 5 da AMD marca a estreia da aceleração completa AVX-512 para a família Ryzen. Ao contrário da Intel, que precisa reduzir as velocidades de clock quando seus processadores executam cargas de trabalho AVX-512, a AMD diz que essas instruções poderosas rodarão nas mesmas velocidades de clock que as operações inteiras padrão. Clark também explicou como a empresa alcançou essa façanha e disse que seus núcleos Zen 5c também podem executar AVX-512 completo.
Abaixo está uma transcrição levemente editada dos pontos-chave de nossa conversa com Clark.
Os núcleos compactos Zen 5c chegarão aos PCs desktop?
A abordagem da AMD para seus núcleos compactos Zen 5c é inerentemente diferente da abordagem da Intel com seus e-cores. Assim como os E-cores da Intel, os núcleos Zen 5c da AMD são projetados para consumir menos espaço em um chip do que os núcleos de desempenho ‘padrão’, oferecendo desempenho suficiente para tarefas menos exigentes, economizando energia e oferecendo mais poder de computação por milímetro quadrado do que era possível anteriormente (análise detalhada aqui). Mas as semelhanças terminam aí. Ao contrário da Intel, a AMD emprega a mesma microarquitetura e suporta os mesmos recursos com seus núcleos menores.
Com o Zen 5, a AMD também projetou os núcleos compactos menores para oferecer quase o mesmo desempenho que os núcleos maiores, evitando que os núcleos Zen 5 mais rápidos esperem pelos núcleos compactos durante cargas de trabalho com múltiplos threads. Clark disse que espera que os núcleos compactos da AMD eventualmente cheguem aos processadores desktop, explicou que a AMD usa uma técnica de colocação de threads para direcionar certas cargas de trabalho para os núcleos menores e expandiu como a AMD reduziu seus núcleos padrão para criar o Zen 5c.
Tom’s Hardware (TH): Quando você vê os núcleos compactos Zen 5c, você acha que eles têm lugar apenas em ambientes com restrições de energia [móveis]? Você poderia ver isso chegando aos PCs desktop, onde a energia não é uma consideração?
Mike Clark (MC): […] Se continuarmos construindo os núcleos compactos da maneira que falamos — o que acho que faremos; não sei por que disse isso de forma um pouco mais teórica — a parte difícil é realmente garantir que acertemos o ponto de frequência certo para que esteja equilibrado com quantos [núcleos] você vai colocar. Mas digamos que você seja realmente bom nisso, então não há razão para não colocar um núcleo compacto em um desktop.
Seja o mesmo desempenho em uma determinada contagem de núcleos para o cliente e mais barato porque há menos área usada, ou podemos espremer ainda mais núcleos em um desktop por causa dos núcleos compactos. E não poderíamos aproveitá-los [núcleos de desempenho] de qualquer maneira porque estavam limitados pelo TDP quando você chegava a tantos núcleos, então você poderia muito bem ter usado um núcleo compacto. Acho que, à medida que ganhamos mais experiência com o Windows e vemos que o agendamento funciona bem, acho que você nos verá, no desktop, usando os núcleos compactos para obter mais núcleos e ser mais econômico. Porque é área desperdiçada [para núcleos de desempenho] porque não podemos rodar tudo naquela frequência de 5,7 GHz.
TH: Ao usar núcleos compactos em um design heterogêneo, você agenda cargas de trabalho nesses núcleos usando algum tipo de colocação de threads?
MC: Não temos nenhum hardware que possa mover núcleos magicamente ou torná-lo transparente para o software, então aproveitamos o software. Podemos construir uma tabela de capacidades dos diferentes núcleos e atualizar dinamicamente essa tabela para dar feedback conforme as coisas acontecem, para que possam gerenciar onde colocar o núcleo para uma carga de trabalho com poucos threads. […] Esperamos que tanto os núcleos clássicos quanto os núcleos de throughput [Zen 5c] acompanhem no mesmo nível e não sejam sobrecarregados pelo núcleo de throughput não ter poder de computação suficiente. O algoritmo funciona na ordem dos núcleos mais lentos, então esses núcleos de throughput podem funcionar em uma frequência bastante alta para que possamos lidar com cargas de trabalho verdadeiramente multithread. Mas então, quando você tem multiprocessamento, precisa ser inteligente sobre onde coloca as coisas.
Você deve testá-lo. Eu não vi, mas você pode rodar o Teams, e verá nos núcleos compactos. Você pode abrir seu navegador, e ele irá para os núcleos de desempenho porque você precisa dessa explosão de desempenho. E então, quando você terminar, ele desaparecerá; o Teams ainda permanecerá nesses núcleos compactos, e você obterá o melhor dos dois mundos.
TH: Quando você olha para o núcleo padrão e o reduz enquanto corresponde de perto às capacidades de desempenho para não ter problemas de dependência de threads, como você consegue isso? Bibliotecas mais densas, espaçamento mais próximo?
MC: É mais o último — a biblioteca é a mesma. […] Existem blocos lógicos e até sub-blocos, mas para atingir a alta frequência em certas vias de velocidade crítica, precisamos dividir o design em pequenas peças, nas quais fazemos um trabalho personalizado. Mas no final do dia, é um retângulo; as coisas estão mais distantes do que precisam estar, há espaço em branco, e isso tudo para atingir aquela alta frequência. Mas então dizemos, ‘Ok, bem, reduza a frequência máxima.’ Então, podemos combinar blocos; não precisamos fazer tanto trabalho personalizado, e isso pode reduzir o design. Agora é naturalmente menor porque utilizamos mais o espaço. Quando era maior, há lógica extra para repetidores e coisas assim, há buffer, e isso tudo é removido.
É incrível o quanto você pode reduzir o núcleo no alvo escolhido para encontrar uma quantidade significativa de área e energia para obter o máximo dele. Foi realmente apenas por causa do que tivemos que fazer para obter aquela alta frequência. Agora, você poderia dizer, ‘Bem, por que você não é melhor em escolher esses pequenos pacotes?’ Mas estamos fazendo isso há anos, e não podemos aperfeiçoar os blocos menores. Está meio que na natureza do design.
Como o Zen 5 funciona em frequências normais ao executar cargas de trabalho AVX-512
TH: Você mencionou que o Zen 5 executa instruções AVX-512 nas mesmas frequências que as instruções padrão. A Intel lutou com isso por muito tempo, e então eles fizeram todo tipo de coisas, como bifurcar as instruções AVX em diferentes classes denotadas pelo uso de energia. O Zen 5 empregou algum ajuste notável para manter as frequências AVX-512 altas? Qual é o seu segredo para o sucesso?
MC: Fundamental para o que eu chamaria de nosso segredo para o sucesso é tentar introduzi-lo em um ponto onde esteja mais equilibrado com o resto da máquina. Isso para que não pareça tão único e para que você não precise tratá-lo como algo tão único, o que leva a todos esses problemas. Agora, obviamente, pode consumir mais energia, mas o AVX-256 também poderia. Mas é melhor que as coisas cresçam juntas. Se você imaginasse tentar colocar AVX-512 no Zen 2, tínhamos acabado de crescer de AVX-128 para AVX-256 naquela época. Eu só tenho essa coisa de equilíbrio; é isso que o Zen é, e está tão em equilíbrio.
Agora, também aprendemos. Mesmo no lado inteiro, nossos agendadores consomem muita energia. E assim, de ambos os lados, acho que o truque é, e tenho certeza de que a Intel também aprendeu isso, é planejar o layout de uma forma que você esteja ciente de onde os pontos quentes estarão, sabendo também que você nunca acerta tudo, então colocando sensores em todos os lugares — mas especialmente onde você está preocupado. Temos sido bons em fazer esses funcionarem e usar nosso firmware para gerenciar isso dinamicamente para que possamos responder melhor. Há momentos em que temos que reduzir a velocidade porque vários núcleos estão usando isso, e está mais limitado pelo TDP. Mas isso acontece no lado inteiro também.
TH: Então as frequências estariam praticamente em sincronia com o inteiro?
MC: É apenas tentar sentir e reagir a isso o suficiente para que não seja, ‘Oh, esse único cara [núcleo] fez isso, e reduzimos a frequência de todos’, e não é realmente uma situação tão séria. Então, é um problema de gerenciamento que aprendemos a entender e implementar em todo o design, não apenas para AVX-512.
TH: Quando olhamos para os núcleos compactos executando AVX-512, eles executam isso com caminho de dados padrão completo, largura completa de 512 bits, ou executam AVX-256 em dobro?
MC: Podemos fazer ambos. Para o que estamos lançando hoje no Strix Point, tanto o núcleo de desempenho quanto o núcleo compacto têm o AVX reduzido [AVX-256] porque estão em uma situação heterogênea e estão em uma plataforma móvel onde a área é um prêmio.
E embora você possa argumentar que poderíamos tentar ter isso, não queremos que o software tenha que lidar com algo assim. Embora tenhamos reduzido no núcleo de desempenho, o que ajuda na área, podemos ter mais núcleos de throughput em algum nível. Mas poderíamos construir um núcleo compacto para outros mercados, e acho que você verá isso onde temos o caminho de dados completo de 512 bits também porque é ótimo para cargas de trabalho de IA e vetor, mesmo que seja um design mais denso, isso não significa que não queira um ótimo desempenho vetorial quando necessário.
O maior desafio do design do Zen 5
TH: Qual foi o maior desafio que você encontrou no desenvolvimento do Zen 5?
MC: Foi realmente lidar com duas tecnologias [projetando o Zen 5 para ambas as tecnologias de processo de 4nm e 3nm], especialmente uma tecnologia que a geração anterior estava. E tentar fazer tantas mudanças e, portanto, a realidade inevitável de que em 4nm vai ser [consumir] mais energia do que vai ser em 3nm, não importa o quão inteligentes sejamos.
Mas precisamos dessa flexibilidade em nosso roadmap, e faz sentido. Mas ainda assim, foi realmente difícil tentar controlar as duas tecnologias e os recursos, e um recurso que parece ótimo em 3nm não parecer tão bom em 4nm por causa do impacto de energia do transistor menos eficiente e como isso afeta o plano de piso. Normalmente, fazemos a arquitetura em uma, e depois portamos para a próxima, e então você tem muito tempo para lidar no plano de piso com as duas tecnologias. […] Foi realmente desafiador. Mas isso dá muito espaço para melhorias no Zen 6.
E vamos entregar 3nm em breve com 4nm; basicamente, estão um em cima do outro. Então, as equipes de design são separadas na construção desses, mas estamos tentando nos comunicar e trabalhar juntos — ainda é o mesmo. Tentamos mantê-lo simples para nossa própria sanidade. Temos todos esses designs que precisamos validar e construir, e quanto mais diferentes eles são, mais as coisas saem de controle. Isso aumenta a complexidade.
Esse foi um desafio, e um que adoramos porque, como eu disse, agora que fizemos isso, aprendemos muito com isso. Vamos conseguir fazer melhor da próxima vez. Isso é o que torna esse trabalho tão divertido: aprendizado constante, novos desafios constantes e inovação constante.
Fonte: Tom’s Hardware