


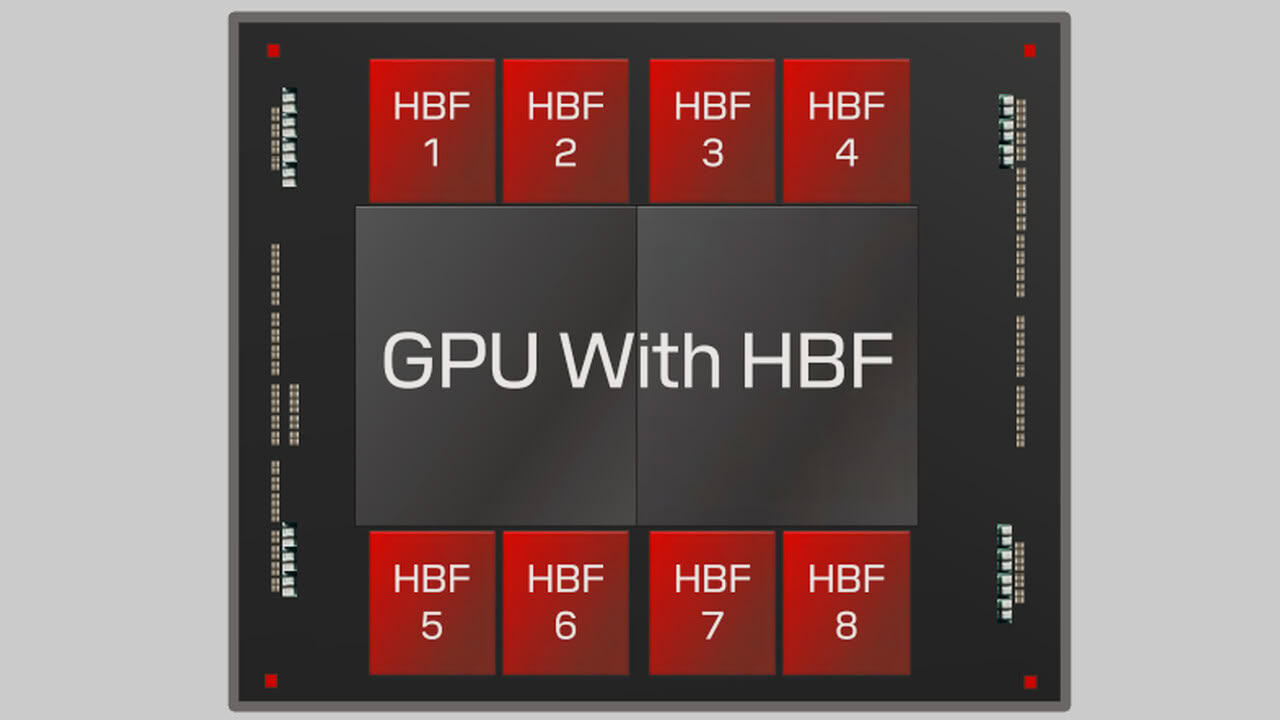

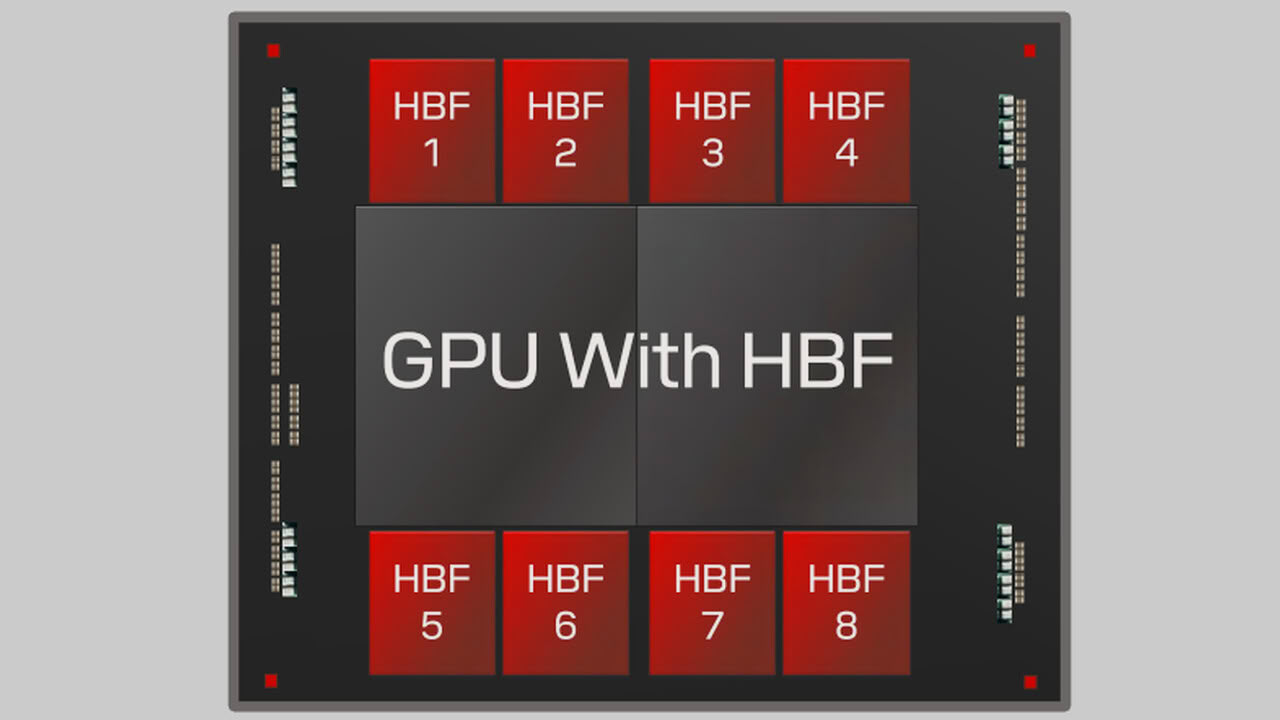
A Micron está estudando colocar memória NAND próxima da GPU — não no fundo do subsistema de armazenamento, atrás de várias camadas de protocolo, mas praticamente colada ao processador gráfico. O objetivo é claro: permitir que modelos de linguagem gigantes rodem em sistemas com menos GPUs.
Segundo reportagem da TechPowerUp, com base em informações do DigiTimes, o conceito é chamado internamente de “near-GPU NAND” e consiste em módulos flash de alta resistência posicionados no próprio pacote ou na PCB da placa de vídeo.
Uma camada nova na hierarquia de memória
Hoje, o caminho dos dados numa carga de IA é bastante desigual. No topo está a HBM, absurdamente rápida e absurdamente cara. Embaixo está o armazenamento em SSD, barato e vasto, mas lento demais para inferência. No meio, um vazio.
É exatamente esse vazio que a proposta pretende ocupar:
- Densidade menor que a NAND TLC ou QLC convencional
- Foco em velocidade de I/O, largura de banda e tempo de leitura, em vez de capacidade máxima
- Centenas de gigabytes acessíveis diretamente pela GPU
- Custo muito abaixo do de HBM ou DRAM convencional
- Resistência elevada, para suportar ciclos intensos de leitura e escrita
Na prática, seria um buffer muito rápido entre a memória da GPU e o armazenamento do sistema. E isso muda a economia da inferência: modelos deixam de ser limitados pela memória, podendo rodar em máquinas com menos placas de vídeo e mais camadas de memória e armazenamento compensando o volume necessário.
A Micron não está sozinha nessa corrida
SK hynix e Sandisk já padronizaram um conceito equivalente sob o nome High-Bandwidth Flash (HBF), com a mesma proposta de estender o espaço de HBM da GPU aproximando a NAND e tornando-a mais durável.
O desafio comum a todos é o mesmo: fechar a lacuna de largura de banda e de resistência. NAND, por natureza, é mais lenta e tem vida útil de escrita limitada em comparação com DRAM. Sem resolver esses dois pontos, a camada intermediária vira gargalo em vez de solução.
Precisa dimensionar armazenamento para IA e dados?
SSDs, storages e servidores com nota fiscal eletrônica, garantia oficial e faturamento empresarial em até 90 dias.
Ver storages na GOIG
Pedir cotação no WhatsApp
Primeira compra? Use o cupom BEMVINDOGOIG e ganhe 5% de desconto.
Por que isso interessa a empresas brasileiras
A conta da IA local hoje esbarra quase sempre no mesmo lugar: memória. Rodar um modelo grande exige VRAM suficiente para mantê-lo residente, e VRAM é justamente o componente cujo preço mais subiu com a demanda dos data centers.
Se a NAND próxima da GPU se consolidar, o efeito para o comprador corporativo é direto: menos placas de vídeo necessárias para o mesmo modelo, ou modelos maiores rodando no mesmo orçamento. Para empresas que precisam manter dados dentro de casa por exigência de LGPD ou por contrato, isso pode ser a diferença entre viabilizar um projeto de IA interna ou continuar dependendo de API externa.
O que não muda no curto prazo
Vale calibrar a expectativa. Isso ainda é pesquisa e padronização, não produto em prateleira. Quem está dimensionando infraestrutura de IA em 2026 precisa trabalhar com o que existe hoje: memória unificada em plataformas compactas, GPUs profissionais com VRAM generosa e SSDs NVMe rápidos para o pipeline de dados.
A boa notícia é que a direção do mercado está clara. Como observa a TechPowerUp, com Micron, SK hynix e Sandisk empurrando o mesmo conceito em paralelo, a chance de virar padrão é alta.
Perguntas frequentes sobre NAND próxima da GPU
O que é near-GPU NAND?
É uma proposta de posicionar módulos de memória NAND de alta resistência no pacote ou na PCB da GPU, criando uma camada intermediária entre a memória gráfica e o armazenamento do sistema.
Isso substitui a HBM?
Não. A ideia é complementar a HBM, oferecendo uma camada mais barata e densa para dados que não exigem a latência extrema da memória de alta largura de banda.
O que é High-Bandwidth Flash?
É o conceito equivalente padronizado por SK hynix e Sandisk, com a mesma proposta de aproximar a NAND da GPU e aumentar sua durabilidade.
Qual a vantagem para rodar LLMs?
Modelos deixam de ser limitados pela memória disponível, permitindo rodar cargas maiores em sistemas com menos GPUs e custo total mais baixo.
Quando essa tecnologia chega ao mercado?
Ainda está em fase de exploração e padronização. Não há previsão de produtos comerciais divulgada pelas fabricantes.
Infraestrutura de IA e dados sob medida
Workstations, servidores, SSDs e storages dimensionados para a sua carga de trabalho, com atendimento consultivo e orçamento rápido.
Ver soluções de IA na GOIG
Falar com um especialista
Faturamento empresarial em até 90 dias e nota fiscal eletrônica para CNPJ.
Fonte original: TechPowerUp, com informações do DigiTimes. Imagem: reprodução / TechPowerUp.