


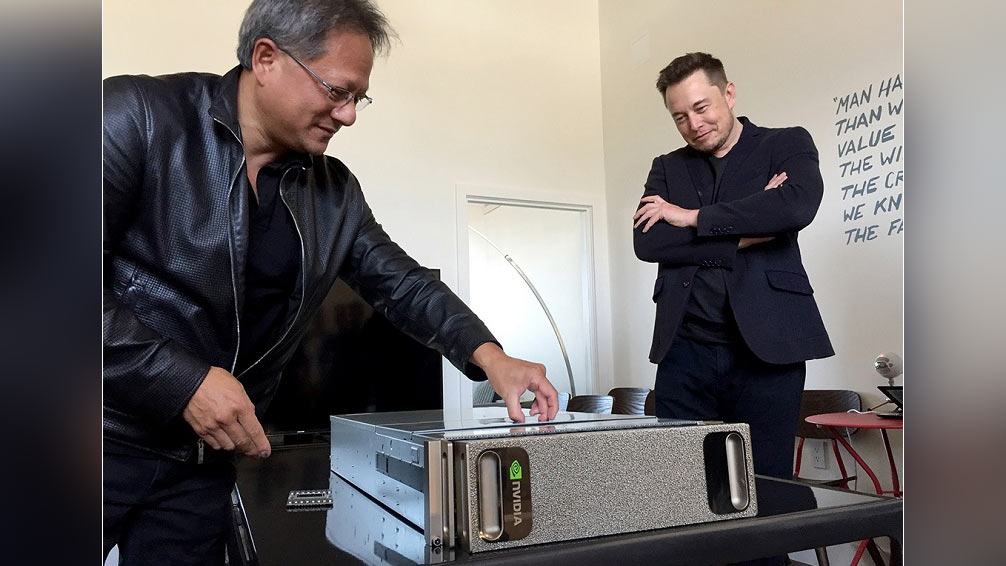
O X de Elon Musk (anteriormente Twitter) trouxe o sistema de treinamento mais poderoso do mundo online. O supercomputador Colossus usa até 100.000 GPUs Nvidia H100 para treinamento e está programado para expandir com mais 50.000 GPUs Nvidia H100 e H200 nos próximos meses.
“Neste fim de semana, a equipe xAI colocou nosso cluster de treinamento Colossus 100K H100 online,” escreveu Elon Musk em um post no X. “Do início ao fim, foi feito em 122 dias. Colossus é o sistema de treinamento de IA mais poderoso do mundo. Além disso, ele dobrará de tamanho para 200K (50K H200) em alguns meses.”
De acordo com Michael Dell, chefe do gigante da tecnologia, a Dell desenvolveu e montou o sistema Colossus rapidamente. Isso destaca que o fabricante de servidores acumulou considerável experiência na implantação de servidores de IA durante o boom da IA nos últimos anos.
Elon Musk e suas empresas têm feito recentemente anúncios relacionados a supercomputadores. No final de agosto, a Tesla anunciou seu cluster de IA Cortex, com 50.000 GPUs Nvidia H100 e 20.000 chips de IA do tamanho de wafer da Tesla. Mesmo antes disso, no final de julho, o X iniciou o treinamento de IA no Memphis Supercluster, composto por 100.000 GPUs H100 resfriadas a líquido. Este supercomputador precisa consumir pelo menos 150 MW de energia, já que 100.000 GPUs H100 consomem cerca de 70 MW.
Embora todos esses clusters estejam formalmente operacionais e até treinando modelos de IA, não está totalmente claro quantos estão realmente online hoje. Primeiro, leva algum tempo para depurar e otimizar as configurações desses superclusters. Em segundo lugar, o X precisa garantir que eles tenham energia suficiente, e enquanto a empresa de Elon Musk tem usado 14 geradores a diesel para alimentar seu supercomputador Memphis, eles ainda não eram suficientes para alimentar todas as 100.000 GPUs H100.
O treinamento do modelo de linguagem grande (LLM) Grok versão 2 da xAI exigiu até 20.000 GPUs Nvidia H100, e Musk previu que versões futuras, como o Grok 3, precisarão de ainda mais recursos, potencialmente cerca de 100.000 processadores Nvidia H100 para treinamento. Para isso, a xAI precisa de seus vastos data centers para treinar o Grok 3 e, em seguida, executar a inferência nesse modelo.
Fonte: Tom’s Hardware