

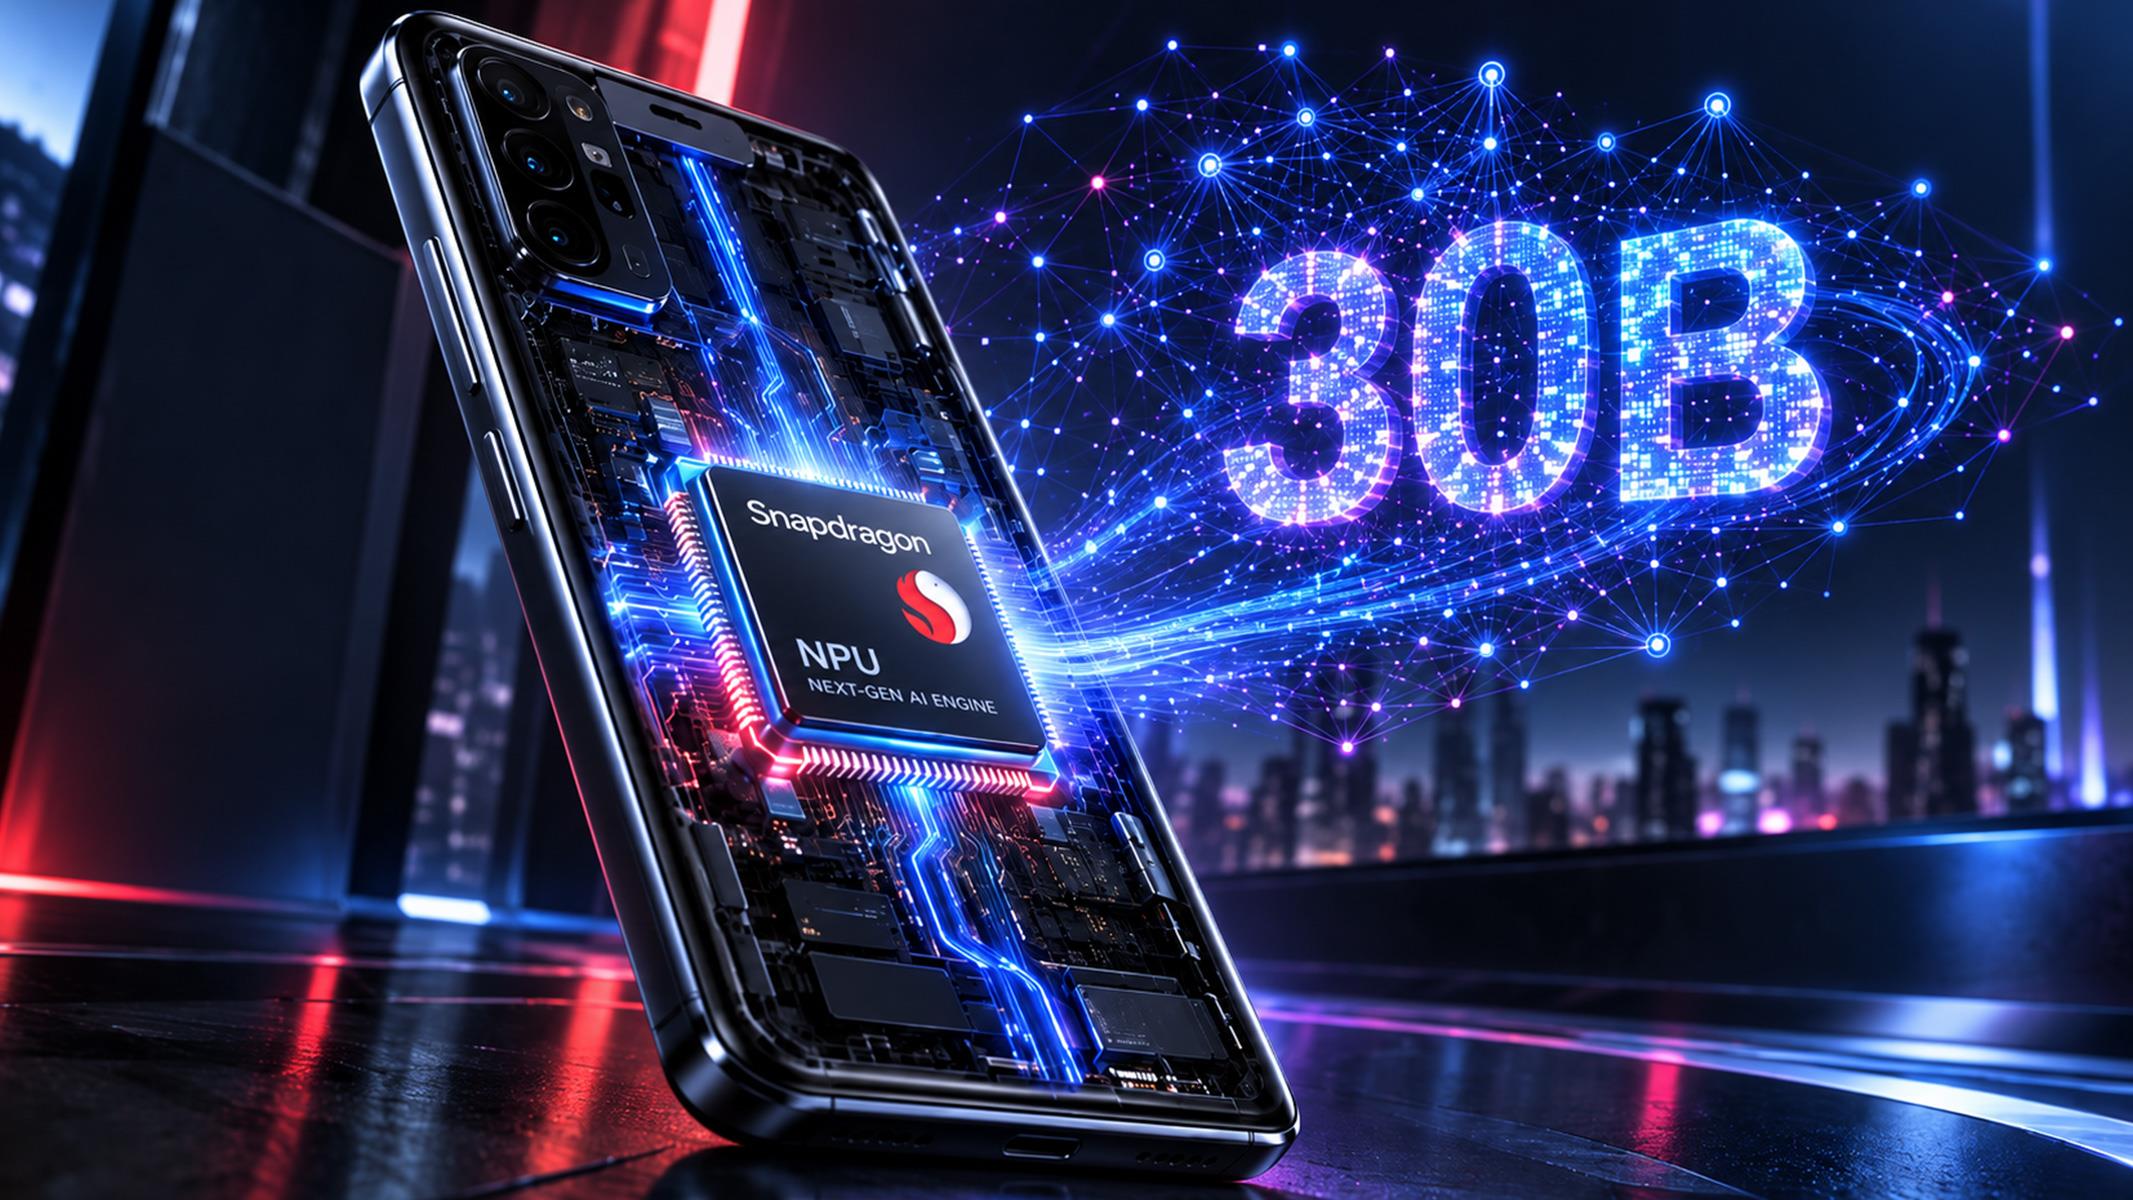
A Qualcomm revelou o terceiro pilar de seu próximo Snapdragon de topo: uma NPU Hexagon completamente redesenhada, construída especificamente para IA agêntica e capaz de rodar modelos de até 30 bilhões de parâmetros localmente no celular. Não na nuvem — no aparelho, sem conexão, sem enviar dados para fora.
Segundo reportagem da HotHardware, a companhia vem divulgando os componentes da nova plataforma em etapas: primeiro a CPU Oryon de 5 GHz, depois o motor gráfico Adreno Neural Fusion e agora a NPU. O quadro completo será apresentado no Snapdragon Summit, que começa em 22 de setembro.
Os dois upgrades de hardware que mudam o jogo
A nova Hexagon traz duas alterações estruturais desenhadas para sustentar cargas de trabalho persistentes e multimodais sem torrar a bateria.
Element Accelerator
O primeiro é um bloco chamado Element Accelerator, que combina extensões vetoriais de alta vazão — para a matemática matricial bruta — com extensões escalares voltadas à lógica de execução, tomada de decisão e roteamento de ferramentas. Essa segunda parte é a pista de que a Qualcomm está mirando agentes, e não apenas inferência de modelo: agentes precisam decidir qual ferramenta chamar, quando e com quais parâmetros.
Memória compartilhada 50% maior
O segundo é a expansão do pool de memória compartilhada, com 50% mais capacidade que a geração anterior. O objetivo é manter estado do modelo, contexto e dados de cache KV mais perto dos aceleradores, reduzindo gargalos de memória. A aceleração de cache KV embutida suporta contextos de até 32 mil tokens — o suficiente para um agente manter uma conversa longa, com várias ferramentas e tarefas simultâneas, sem perder o fio.
Mixture-of-Experts: o truque que torna 30B viável no celular
Rodar um modelo de 30 bilhões de parâmetros em um smartphone parece impossível — e seria, com arquitetura densa tradicional. O gargalo não é poder de cálculo, é largura de banda de memória.
A solução da Qualcomm é migrar para arquiteturas Mixture-of-Experts (MoE). Em vez de ativar a rede inteira a cada requisição, um modelo MoE de 30 bilhões de parâmetros mantém toda a base de conhecimento disponível no dispositivo, mas ativa apenas cerca de 3 bilhões de parâmetros roteados por token gerado. O modelo seleciona dinamicamente quais “especialistas” acionar conforme a entrada.
- Parâmetros totais do modelo: até 30 bilhões
- Parâmetros ativos por token: aproximadamente 3 bilhões
- Contexto suportado: até 32.000 tokens
- Memória compartilhada: 50% maior que a geração anterior
- Gerenciamento: técnicas de flash-to-memory e cache para os especialistas
O resultado prático é entregar experiência de modelo grande com consumo de energia e de memória de modelo pequeno.
Sua empresa está avaliando infraestrutura para IA?
Do kit de desenvolvimento à estação de trabalho com GPU dedicada, a GOIG monta a configuração certa para rodar IA localmente.
Na GOIG você compra com nota fiscal eletrônica para CNPJ, faturamento empresarial em até 90 dias, 12x sem juros no cartão e 10% de desconto no PIX. Primeira compra? Use o cupom BEMVINDOGOIG e ganhe 5% off.
Por que IA local importa para empresas brasileiras
A tendência de processar IA no próprio dispositivo — e não na nuvem — tem implicações diretas para o mercado corporativo nacional:
- LGPD e soberania de dados: processar localmente elimina o envio de informação sensível para servidores de terceiros, simplificando compliance
- Custo previsível: sem cobrança por token ou por chamada de API, o custo vira CAPEX único em vez de OPEX variável
- Independência de conectividade: operações em campo, fábrica ou área remota continuam funcionando sem internet estável
- Latência: resposta imediata, sem ida e volta até um data center no exterior
Esse movimento não está restrito ao celular. A mesma lógica vem empurrando a adoção de estações de trabalho com GPU dedicada e kits de desenvolvimento voltados a inferência local dentro das empresas — uma categoria que cresceu rapidamente nos últimos ciclos.
O que esperar do Snapdragon Summit
Com CPU, GPU e NPU já detalhadas separadamente, a Qualcomm chega ao evento de 22 de setembro com o desenho completo de sua plataforma para IA agêntica em dispositivos de baixo consumo. Como observou a HotHardware, o conjunto soa promissor — mas números de arquitetura só valem quando confrontados com desempenho real medido em aparelhos comerciais.
Para o comprador corporativo, o recado é de planejamento: a próxima geração de dispositivos móveis e de notebooks com Snapdragon vai trazer capacidade de IA local significativamente maior, e isso deve entrar na conta de qualquer projeto de renovação de frota previsto para 2027.
Perguntas frequentes
O que a nova NPU Hexagon da Qualcomm faz de diferente?
Ela adiciona um Element Accelerator, que combina extensões vetoriais e escalares para acelerar cargas de trabalho transformer e lógica de agentes, além de 50% mais memória compartilhada.
Como um celular consegue rodar um modelo de 30 bilhões de parâmetros?
Pela arquitetura Mixture-of-Experts. O modelo mantém todos os 30 bilhões de parâmetros disponíveis no dispositivo, mas ativa apenas cerca de 3 bilhões por token gerado, reduzindo drasticamente a demanda de cálculo e de banda de memória.
Qual o tamanho de contexto suportado?
A aceleração de cache KV embutida suporta contextos de até 32.000 tokens.
Quando a Qualcomm apresenta a plataforma completa?
No Snapdragon Summit, que começa em 22 de setembro de 2026.
Por que rodar IA localmente é vantajoso para empresas?
Processar localmente melhora a conformidade com a LGPD, elimina custo variável por chamada de API, reduz latência e garante funcionamento mesmo sem conectividade estável.
Prepare sua infraestrutura para a onda de IA local
Workstations, GPUs, kits de desenvolvimento e armazenamento de alta performance. Fale com um especialista e receba uma proposta técnica.
Na GOIG você compra com nota fiscal eletrônica para CNPJ, faturamento empresarial em até 90 dias, 12x sem juros no cartão e 10% de desconto no PIX. Primeira compra? Use o cupom BEMVINDOGOIG e ganhe 5% off.
Fonte: HotHardware, com informações da Qualcomm.