

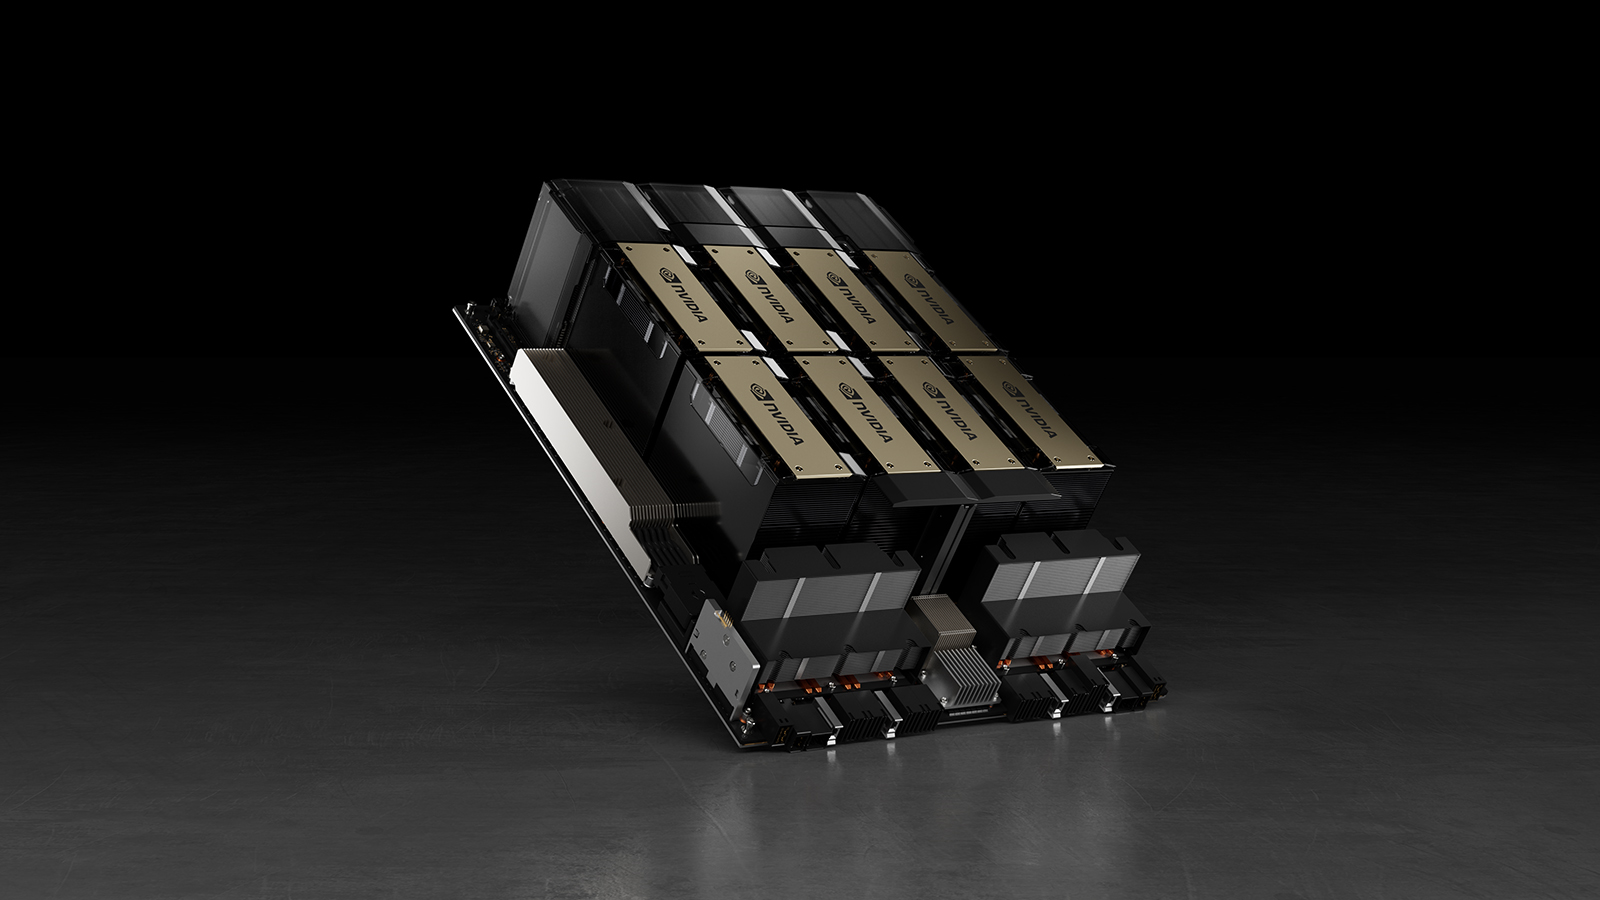
Meta recentemente liberou um estudo detalhando o treinamento do modelo Llama 3 405B em um cluster contendo 16.384 GPUs Nvidia H100 80GB. O treinamento ocorreu ao longo de 54 dias e o cluster enfrentou 419 falhas inesperadas de componentes durante esse período, em média uma falha a cada três horas. Em metade dos casos de falha, as GPUs ou suas memórias HBM3 foram as culpadas.
Como diz o velho ditado da supercomputação, a única certeza com sistemas em larga escala é a falha. Supercomputadores são dispositivos extremamente complexos que utilizam dezenas de milhares de processadores, centenas de milhares de outros chips e centenas de quilômetros de cabos. Em um supercomputador sofisticado, é normal que algo quebre a cada poucas horas, e o principal truque para os desenvolvedores é garantir que o sistema permaneça operacional independentemente de tais falhas locais.
A escala e a natureza síncrona do treinamento com 16.384 GPUs tornam-no propenso a falhas. Se as falhas não forem mitigadas corretamente, uma única falha de GPU pode interromper todo o trabalho de treinamento, necessitando de um reinício. No entanto, a equipe do Llama 3 manteve mais de 90% do tempo de treinamento efetivo.
Durante um snapshot de pré-treinamento de 54 dias, houve 466 interrupções de trabalho, com 47 planejadas e 419 inesperadas. As interrupções planejadas foram devido à manutenção automatizada, enquanto as inesperadas, na maioria das vezes, surgiram de problemas de hardware. Problemas com GPUs foram a maior categoria, representando 58,7% das interrupções inesperadas. Apenas três incidentes exigiram intervenção manual significativa; o restante foi gerenciado por automação.
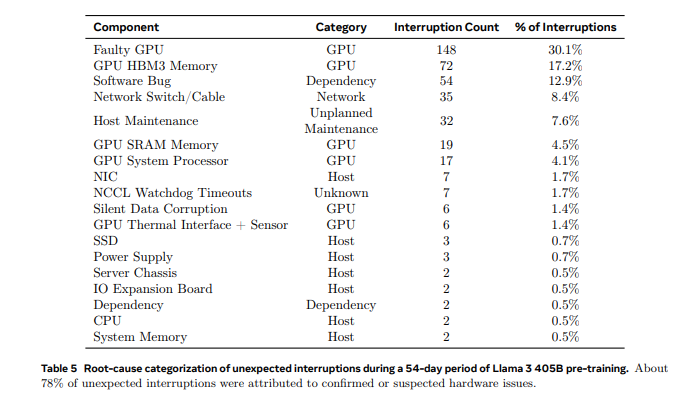
Mas enquanto as GPUs são os componentes mais importantes e também frágeis, 41,3% das interrupções inesperadas foram causadas por inúmeros fatores, incluindo bugs de software, cabos de rede e adaptadores de rede.
Para aumentar a eficiência, a equipe da Meta reduziu os tempos de inicialização e checkpoint dos trabalhos e desenvolveu ferramentas de diagnóstico proprietárias. O gravador de voo NCCL do PyTorch foi usado extensivamente para diagnosticar e resolver rapidamente travamentos e problemas de desempenho, particularmente relacionados ao NCCLX. Esta ferramenta captura metadados coletivos e rastreamentos de pilha, ajudando na rápida resolução de problemas.
O NCCLX desempenhou um papel crucial na detecção e localização de falhas, especialmente para problemas relacionados ao NVLink e RoCE. A integração com o PyTorch permitiu o monitoramento e o timeout automático de travamentos de comunicação causados por falhas de NVLink.
GPUs lentas, que podem desacelerar milhares de outras GPUs, foram identificadas usando ferramentas especializadas. Essas ferramentas priorizaram comunicações problemáticas, permitindo a detecção eficaz e a resolução oportuna de GPUs lentas, o que garantiu que os atrasos fossem minimizados, mantendo a eficiência geral do treinamento.
Fatores ambientais, como flutuações de temperatura ao meio-dia, impactaram o desempenho do treinamento, causando uma variação de 1-2% na taxa de transferência. A variação dinâmica de tensão e frequência das GPUs foi afetada por essas mudanças de temperatura, embora não tenha sido um grande problema.
Outro desafio enfrentado pela equipe de treinamento do Llama 3 405B LLM é a mudança simultânea de consumo de energia de dezenas de milhares de GPUs, o que estressa a rede elétrica do data center. Essas flutuações, às vezes na casa dos dezenas de megawatts, esticaram os limites da rede, o que significa que a Meta precisa garantir que seus data centers tenham energia suficiente.
Considerando o fato de que um cluster de 16.384 GPUs experimentou 419 falhas em 54 dias (7,76 vezes a cada 24 horas, ou uma falha a cada três horas), podemos apenas imaginar com que frequência o cluster da xAI contendo 100.000 GPUs H100, um aumento de seis vezes no número de componentes que podem falhar, experimentará uma falha.
Fonte: Tom’s Hardware