

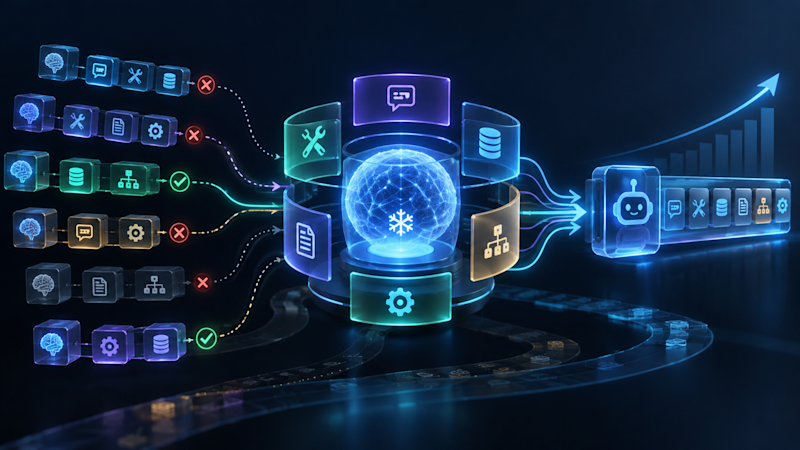
Uma pesquisa da Salesforce mostra que agentes de IA podem mais que dobrar a taxa de conclusão de tarefas em navegador sem trocar o modelo de linguagem por trás deles. O ganho veio da camada em volta do modelo: prompts, ferramentas, habilidades e fluxo de controle. Para quem compra tecnologia, a leitura é direta: o gargalo quase nunca está só no modelo.
Segundo reportagem da VentureBeat, o framework DarwinX, criado pela Salesforce AI Research com a equipe do Agentforce, elevou o desempenho de um agente no benchmark WebArena-Infinity de 43,5% para 93% com o modelo base congelado. O teste final usou 1.260 tarefas inéditas com verificadores determinísticos, e o resultado passou por uma auditoria que descartou trajetórias inválidas.
O que a Salesforce mexeu (e o que deixou intacto)
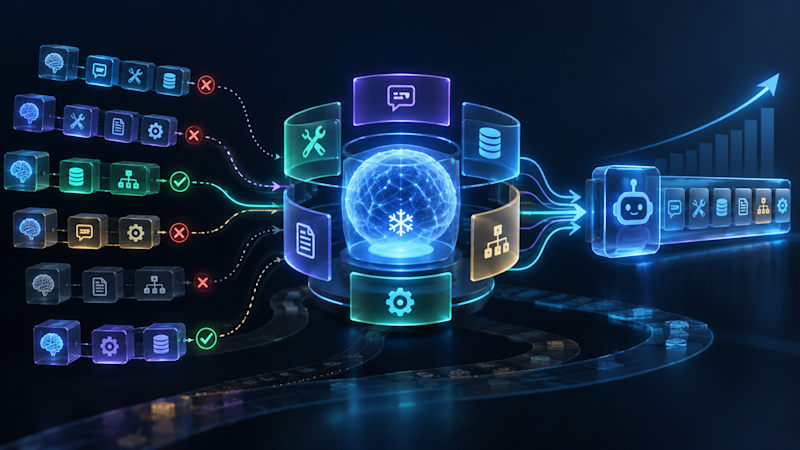
DarwinX não toca nos pesos do modelo. Altera só o que os pesquisadores chamam de harness: instruções, ferramentas, habilidades e regras de fluxo. Em vez de reescrever uma única versão, o sistema cria variantes e só promove uma mudança quando ela resolve algo novo sem quebrar o que já funcionava.
A pesquisa aponta dois problemas conhecidos de quem ajusta prompt na mão. A dependência de caminho, em que a correção de hoje vira base de todas as próximas e trava o sistema num beco sem saída. E a interferência entre tarefas, quando um ajuste que ajuda um processo estraga outro em silêncio.
Os números que valem a leitura
- WebArena-Infinity: de 43,5% para 93%, com modelo congelado e harness evoluído a partir de 300 intenções sintéticas geradas da documentação das aplicações.
- Terminal-Bench 2.1: o agente Monet subiu de 75,5% para 83,2% e chegou a 84,7% com um modelo base mais forte. Computação científica e machine learning ganharam 14,8 pontos; dados e banco de dados, 13,8 pontos.
- TerminalWorld: harness evoluído em 94 tarefas, congelado e testado em outras 41. A versão base resolveu 25 de 41; a DarwinX, 28.
- SWE-bench Verified: 84,2% contra 80,8% do harness de referência, sem feedback desse benchmark durante a evolução.
Um detalhe operacional vale mais que os placares. O agente evoluído não passou a gastar mais processamento em tudo. Nas tarefas que ambas as versões já resolviam, a mediana de turnos subiu de 12 para 13. Em seis tarefas novas, dobrou de 11 para 22. O sistema aprendeu onde valia insistir.
Vai montar a base de máquinas para rodar e testar agentes de IA?
Na GOIG sua empresa compra com nota fiscal eletrônica para CNPJ, garantia de canal oficial e orçamento rápido com especialista. Faturamento empresarial em até 90 dias, 12x sem juros no cartão ou 10% de desconto no PIX.
Por que isso vira problema de infraestrutura
Se a melhoria mora fora do modelo, ela depende de algo que a empresa precisa montar: avaliação. O ciclo roda o agente várias vezes, compara variantes e repete testes para lidar com ruído. Isso consome processamento, armazenamento para trajetórias e logs, e um ambiente de teste que reproduza o cenário real.
Ran Xu, autor sênior do trabalho, resume em declarações ao VentureBeat que o ajuste manual costuma travar em um ótimo local: você conserta um modo de falha e, sem regressão ampla, quebra algo que já funcionava. Para ele, o harness concentra o que é específico da empresa, como dados vivos, permissões, governança e integrações, enquanto o modelo cuida do raciocínio genérico.
A Salesforce liberou a infraestrutura de experimentação no Beagle, projeto aberto no GitHub sob licença Apache 2.0. O agente Monet segue proprietário, mas equipes podem levar o próprio harness para dentro do Beagle.
O que dá para rodar local e o que exige nuvem
Aqui vale honestidade técnica. Os modelos do estudo são hospedados e acessados por API. Ninguém vai rodar um modelo de fronteira dentro do escritório. O que fica local é tudo o mais, e não é pouco:
- Fica local: o harness, o repositório de prompts e habilidades, conectores e ferramentas internas, o banco de trajetórias e logs, a suíte de regressão, a indexação de documentos e modelos abertos menores para classificação, extração e triagem.
- Exige nuvem ou API: o modelo grande que sustenta o raciocínio, as rodadas pesadas de avaliação em paralelo e qualquer treinamento com volume relevante.
Na prática, o time precisa de estações com GPU dedicada e VRAM suficiente para prototipar, RAM folgada para ambientes de teste em paralelo e armazenamento NVMe rápido, porque trajetória de agente gera log em volume. Dimensione o storage pensando em meses de histórico, não em semanas.
Por onde a empresa brasileira começa
Nada disso começa comprando plataforma. Começa escolhendo um processo com resultado verificável. O estudo diz que a técnica não se justifica em fluxo simples e estável, do tipo transformar uma entrada conhecida em chamada de API fixa. Ela rende em tarefas longas. Um roteiro para os primeiros 90 dias:
- Escolher um processo com critério objetivo de sucesso, como conciliação, abertura de chamado ou extração de dados.
- Registrar o que acontece hoje: ações, correções humanas, aprovações e resultado final. Isso vira base de avaliação.
- Montar uma suíte de regressão pequena, com 30 a 50 casos reais, antes de automatizar.
- Rodar o ciclo com orçamento fixo e parar quando o ganho marginal não compensar.
- Separar o ambiente de teste do de produção, com máquina dedicada.
Sobre custo no Brasil, não há preço oficial porque nada disso é produto de prateleira. O gasto se divide entre consumo de API em dólar, que varia com o volume de avaliação, e o hardware local, em real com imposto e frete. Quem tem parque antigo descobre que o freio é memória e disco, não GPU.
Perguntas frequentes
Preciso treinar um modelo próprio para ter ganho com agentes de IA?
Não. No estudo da Salesforce, todos os ganhos vieram com o modelo base congelado, alterando prompts, habilidades, ferramentas e fluxo de controle. A melhoria fica numa camada que a equipe de TI já controla, sem acesso aos pesos do modelo.
Dá para rodar agentes de IA sem nuvem, só com máquinas locais?
Parcialmente. O modelo grande de raciocínio segue hospedado e acessado por API. Local ficam o harness, as ferramentas internas, a base de logs, a suíte de avaliação e modelos abertos menores. É um cenário híbrido, e o dimensionamento local pesa mais em RAM e armazenamento do que a maioria imagina.
Que máquina a equipe precisa para começar a testar?
Uma estação com GPU dedicada, VRAM compatível com os modelos abertos que você pretende usar, RAM folgada para ambientes de teste simultâneos e SSD NVMe para gravar trajetórias. Não existe configuração única: depende do tamanho dos modelos locais e de quantos testes rodam em paralelo.
Esse resultado de 93% significa que o agente acerta 93% das tarefas reais?
Não. O número vale para o benchmark WebArena-Infinity, com 1.260 tarefas inéditas e verificadores determinísticos, após auditoria das trajetórias. Benchmark não é produção: em processos reais raramente existe um verificador binário limpo, e por isso a empresa precisa construir a própria suíte de avaliação.
Sua equipe já sabe qual máquina aguenta o ciclo de testes de agentes?
Fale com um especialista da GOIG e receba um orçamento montado para o seu cenário. Primeira compra tem 5% de desconto com o cupom BEMVINDOGOIG.