

A corrida por servidor de IA ganhou um nome inesperado. A Apple estaria desenvolvendo um equipamento corporativo em torno dos seus chips M-series Ultra, com lançamento apontado para 2029. Seria o primeiro servidor da empresa em quase duas décadas. Fica o aviso desde já: é relato de imprensa, não anúncio. A Apple não comentou.
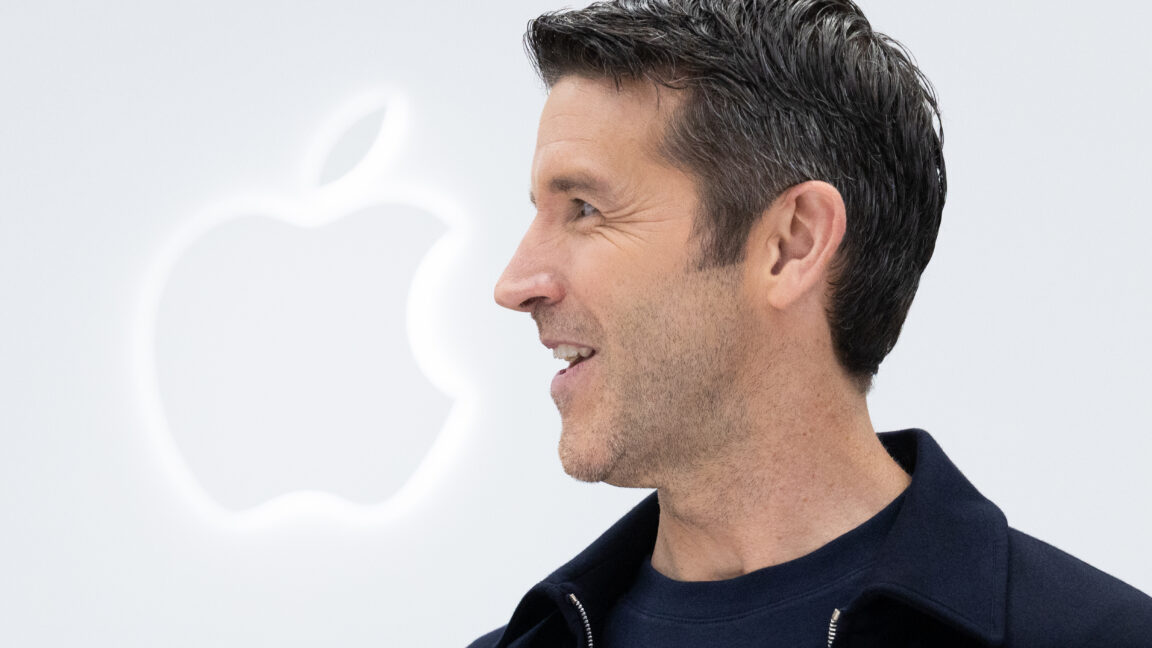
Segundo reportagem da Ars Technica, que cita apuração do site The Information, o produto viria em duas configurações: com dois ou com quatro chips M8 Ultra. O projeto teria começado há cerca de um ano, com apoio de John Ternus, então responsável pela engenharia de hardware e hoje presidente executivo da Apple.
O que dizem os relatos e o que não está confirmado
Nada disso é oficial. Tudo vem de apuração jornalística sobre um projeto que está a três anos de distância. Pode mudar de formato, perder componentes ou ser cancelado.
- Configurações citadas: dois ou quatro chips M8 Ultra por equipamento
- Interconexão entre chips: NVLink Fusion, da NVIDIA, no lugar da solução própria da Apple
- Público-alvo: empresas, desenvolvedores e governos
- Uso principal: inferência, ou seja, rodar modelos já treinados
- Previsão de lançamento: 2029, sem garantia
O portal brasileiro Adrenaline acrescenta contexto: a volta ao rack viria 15 anos depois de a Apple tirar o Xserve de linha. O site registra ainda o acelerador de inferência apelidado de Baltra, feito com a Broadcom em 3 nanômetros pela TSMC, previsto para o fim de 2026 ou início de 2027 e voltado a serviços internos. O rack com M8 Ultra seria o produto de prateleira.
Por que a NVIDIA entra na história
O detalhe técnico mais revelador é a interconexão. A solução que a Apple usa hoje foi desenhada para unir dois dies dentro do mesmo encapsulamento. Esticar isso para um rack inteiro sai caro e lento. Daí a conversa em torno do NVLink Fusion, que abre a interconexão da NVIDIA para processadores e aceleradores de terceiros, como no acordo com a ARM.
Há ressalva: um relato de agosto apontou que essa abertura é menor do que parece, porque exige amarrar o chip de fora a produtos da própria NVIDIA. A Apple, aliás, já usa GPUs da NVIDIA em nuvem para ampliar o Private Cloud Compute.
Nuvem ou máquina local: a decisão que sua empresa toma agora
O que interessa ao comprador brasileiro não é o rack de 2029, e sim o motivo de ele estar sendo desenhado. Empresas passaram a comprar Mac mini e Mac Studio em quantidade para montar pequenos clusters e rodar modelos localmente, em vez de alugar GPU por hora. O movimento é forte o bastante para a Apple avaliar um produto dedicado. A pergunta prática é onde sua inferência deve rodar:
- Volume: carga constante favorece máquina local, porque o custo por hora da nuvem não cai com o uso. Picos esporádicos favorecem nuvem.
- Dados sensíveis: manter dados pessoais ou contratos dentro da rede simplifica a conversa de LGPD e auditoria.
- Latência: aplicação em tempo real sofre com a ida e volta à nuvem.
- Amortização: a workstation costuma se pagar quando substitui fatura recorrente de GPU alugada por mais de 12 a 18 meses.
Vai tirar a IA da nuvem e trazer para dentro da empresa?
Na GOIG sua empresa compra com nota fiscal eletrônica para CNPJ, garantia de canal oficial e orçamento rápido com especialista. Faturamento empresarial em até 90 dias, 12x sem juros no cartão ou 10% de desconto no PIX.
Memória e consumo: o que realmente limita uma máquina de inferência
Quem monta infraestrutura de IA local descobre rápido que o gargalo raramente é o poder bruto de cálculo. É a memória disponível para o modelo.
VRAM em placa dedicada
Em workstation com GPU discreta, o modelo precisa caber na VRAM da placa. Se não couber, você divide a carga entre várias GPUs ou roda parte em memória do sistema e vê o desempenho despencar. Por isso a especificação começa pela pergunta: qual o tamanho do modelo e em qual quantização.
Memória unificada
A arquitetura dos chips da Apple segue caminho diferente, com um pool único de memória compartilhado entre CPU e GPU. Permite carregar modelos grandes sem placa dedicada, com banda menor que a de uma GPU top de linha, mas sem o teto rígido da VRAM. É a característica que explica a adoção de Mac mini e Mac Studio por times de IA, e a lógica que sustentaria o rack dos relatos.
Energia e calor
Inferência contínua é carga constante, não pico. Máquina ligada o dia inteiro muda o dimensionamento do circuito, do nobreak e da refrigeração. Some o consumo real em watts, aplique o fator de potência do nobreak e confira o disjuntor do ambiente.
O que isso muda no Brasil
No curto prazo, nada. Não existe produto anunciado, nem preço, nem previsão de disponibilidade no Brasil. Equipamento apontado para 2029 e não confirmado pelo fabricante não entra em planejamento de compra. Quem especificar infraestrutura em 2026 e 2027 trabalha com o que existe hoje: workstation com GPU dedicada, servidor de rack convencional e, no ecossistema Apple, os desktops que a Ars Technica aponta como alvo de procura entre desenvolvedores de IA.
O sinal de mercado, esse sim, é útil. Fabricantes estão projetando produtos para empresas que querem rodar IA em casa, não só na nuvem. A opção local tende a ficar mais viável e com mais escolha de arquitetura. Vale desenhar a solução de forma modular: uma ou duas máquinas de inferência primeiro, escalando conforme o uso real se confirma.
Perguntas frequentes
A Apple confirmou o servidor de IA?
Não. O projeto foi descrito por reportagens do The Information, repercutidas pela Ars Technica e por veículos brasileiros. A Apple não se manifestou publicamente sobre o assunto. Como o lançamento seria apenas em 2029, o produto pode mudar de forma ou nem existir.
O que é inferência e por que exige hardware específico?
Inferência é rodar um modelo já treinado para gerar respostas, diferente do treinamento, que cria o modelo. Exige memória para carregar o modelo inteiro e banda alta para manter a velocidade de resposta. Por isso a especificação prioriza capacidade de memória antes de cálculo bruto.
Vale mais a pena nuvem ou máquina local para IA?
Depende do padrão de uso. Carga constante e previsível costuma favorecer a máquina local, que se paga quando substitui uma fatura recorrente de GPU alugada por mais de 12 a 18 meses. Picos esporádicos e experimentação inicial favorecem a nuvem. Dados sensíveis e exigência de baixa latência pesam a favor do equipamento próprio.
Quanta memória preciso em uma workstation de inferência?
O ponto de partida é o tamanho do modelo que você pretende rodar e a quantização usada. O modelo precisa caber na memória do acelerador, seja VRAM de uma GPU dedicada, seja o pool unificado em arquiteturas que compartilham memória entre CPU e GPU. Dimensionar por baixo é o erro mais comum e o mais caro de corrigir depois.
Monte sua infraestrutura de IA local com quem dimensiona antes de vender
Fale com um especialista da GOIG e receba um orçamento montado para o seu cenário. Primeira compra tem 5% de desconto com o cupom BEMVINDOGOIG.