

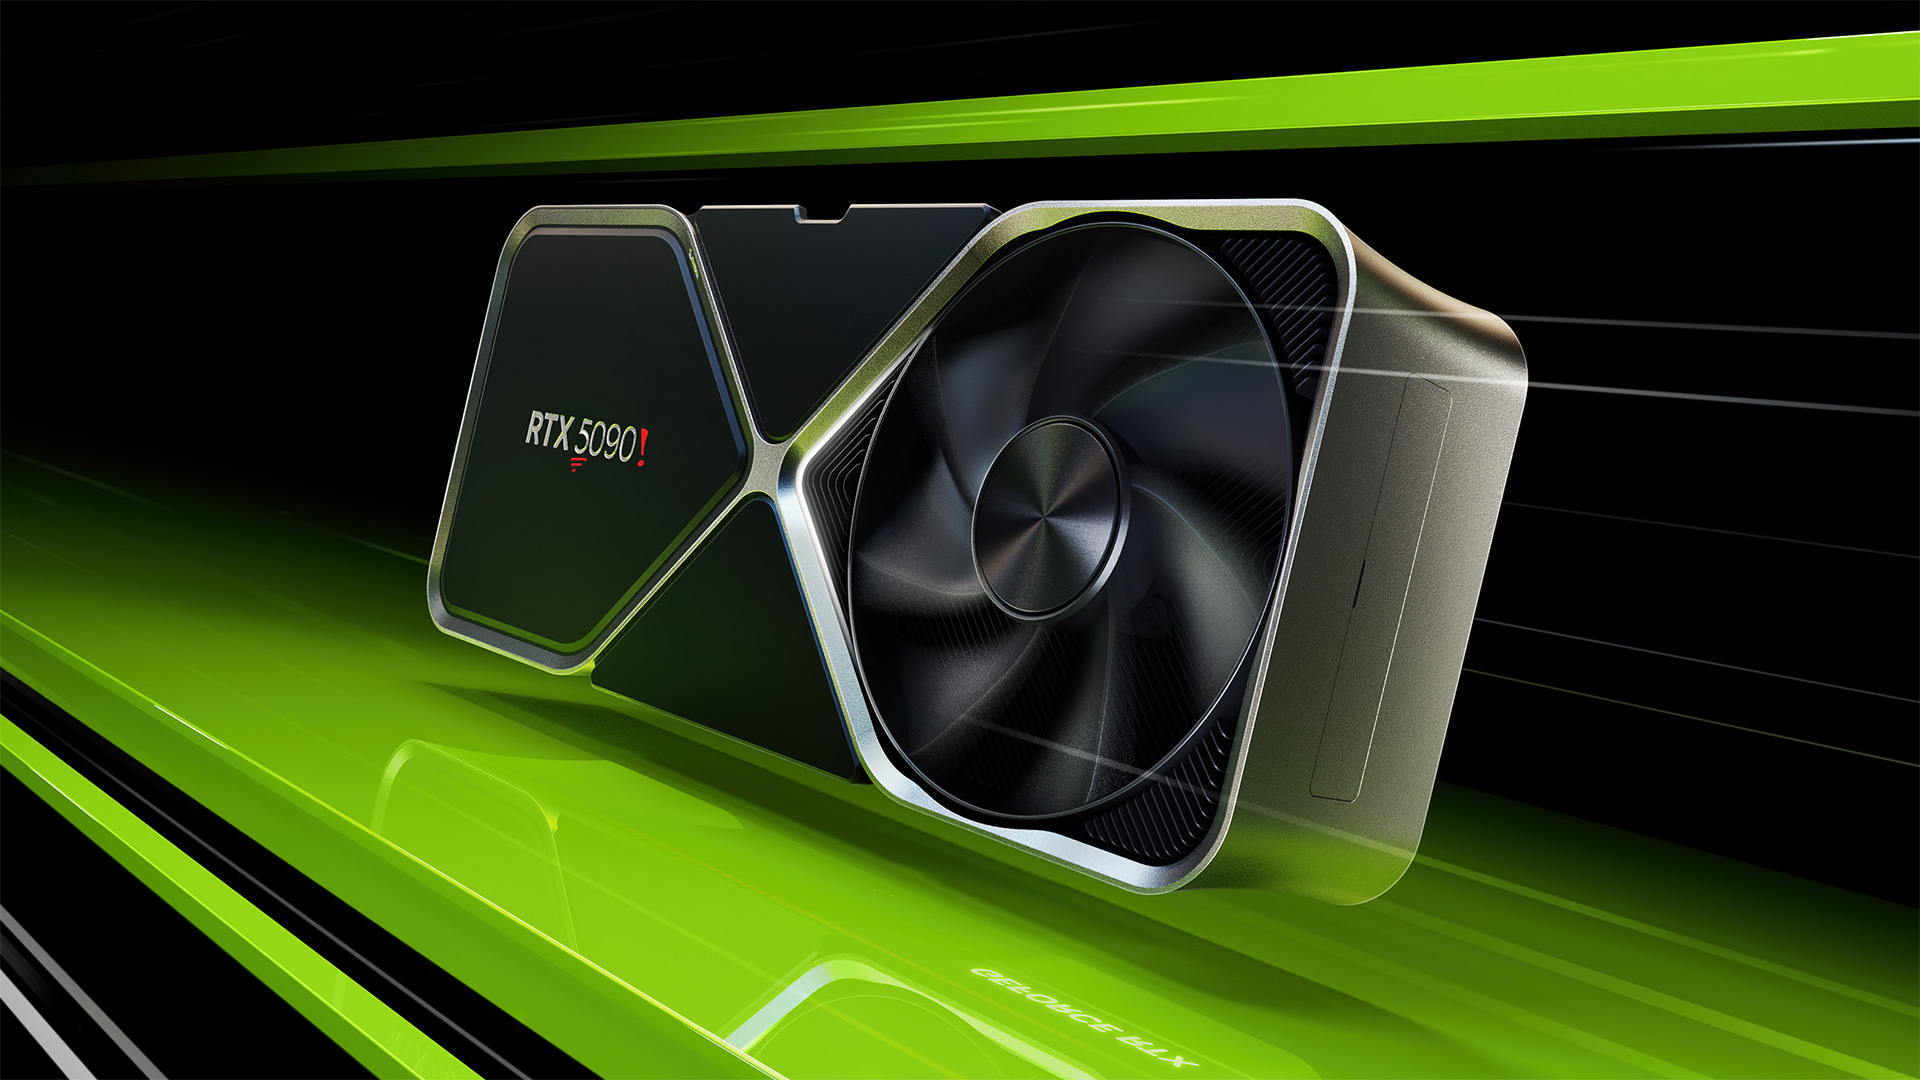
Especificações preliminares das placas de vídeo GeForce RTX 5080 e GeForce RTX 5090 da Nvidia foram publicadas por @kopite7kimi, um leaker de hardware respeitável que tende a ter acesso a informações precisas sobre os próximos produtos da Nvidia. Se as especificações estiverem corretas, a GeForce RTX 5090 da Nvidia será um monstro com uma classificação de potência total de gráficos (TGP) de 600W. Muitas dessas especificações coincidem com vazamentos anteriores, apenas com um pouco mais de detalhes em algumas áreas. Você pode ver nosso guia Nvidia Blackwell RTX 50-series GPUs para mais detalhes.
A GeForce RTX 5090 da Nvidia — a GPU Blackwell carro-chefe para PCs desktop — deverá ser baseada no processador gráfico GB202 com 21.760 núcleos CUDA, acoplada com 32GB de memória GDDR7 usando uma interface de 512 bits. Esse número massivo de núcleos FP32 consumirá uma quantidade enorme de energia, até 600W se o vazamento estiver correto. A placa certamente estará entre as melhores placas de vídeo quando for lançada, mesmo que as especificações finais sejam um pouco menos impressionantes. Só não pergunte sobre os preços…
Em contraste, a GeForce RTX 5080 da Nvidia é dita ser alimentada pela GPU GB203 e contará com 10.752 núcleos CUDA, o que é aproximadamente metade da oferta de topo de linha. As placas de vídeo RTX 5080 agora são projetadas para vir com 16GB de memória GDDR7 com uma interface de 256 bits, com uma classificação TGP de 400W. Com um aumento decente na largura de banda habilitado pelo GDDR7, a RTX 5080 deve superar significativamente sua predecessora em altas resoluções e deve ser uma potente placa de vídeo.
Especificações preliminares das placas de vídeo Nvidia GeForce RTX 5000-series
Enquanto o potencial de desempenho massivo da GeForce RTX 5090 certamente chama a atenção, outra coisa que chama a atenção é o enorme abismo de desempenho entre a RTX 5090 carro-chefe e sua irmã menor, a RTX 5080. É quase exatamente metade do processador gráfico de topo de linha em termos de número de processadores de fluxo e interfaces de memória. O TGP será dois terços da placa de nível superior, então os clocks podem ser mais altos para tentar diminuir a lacuna, mas isso representa uma diferença ainda maior do que com as GPUs da série 40.
Essa disparidade potencial de desempenho parece estranha, para dizer o mínimo, e sugere que a Nvidia pode querer tentar criar um novo nível de desempenho — ou talvez limitar o apelo de certas placas de consumo como alternativas de computação AI. No papel, a RTX 4090 oferece 68% mais núcleos de GPU, 50% mais VRAM, 41% mais largura de banda de memória e 13% mais cache L2 do que a RTX 4080. Na prática, os limites da CPU seguram a 4090 em configurações mais baixas, mas em 4K ultra ela acabou sendo cerca de 35% mais rápida do que a GPU de segunda camada da série 40 — e a RTX 3090 era apenas cerca de 15% mais rápida do que a RTX 3080. Mas essas especificações, se corretas, sugerem que a 5090 poderia ter até o dobro do desempenho da 4080.
Embora não possamos dizer com certeza por que a Nvidia decidiu construir sua linha de próxima geração dessa maneira, uma das explicações técnicas poderia ser que o processador GB202 da Nvidia pode consistir em dois dies GB203. Usar um design multi-chiplet para GPUs Blackwell tem sido rumor por um tempo e as GPUs de datacenter GB100/GB200 de fato adotam essa arquitetura. No entanto, usar embalagem CoWoS-L para habilitar a interconexão de alta velocidade (~10 TB/s) entre dies para um produto de consumo parece uma ideia muito cara.
Uma alternativa à construção de uma GPU multi-chiplet seria construir um processador gráfico monolítico com mais de 21.760 núcleos CUDA na tecnologia de processo de classe 4nm da TSMC, o que resultaria em um die de cerca de 650 mm^2. Tal design é difícil de produzir devido ao grande tamanho do die, razão pela qual redundâncias geralmente estão presentes — o chip AD102 da 4090, por exemplo, tem um máximo de 144 Multiprocessadores de Streaming (SMs), mas apenas 128 estão habilitados. Então não é impossível para a Nvidia seguir esse caminho se quiser. Um chip monolítico também seria muito caro, no entanto, e seria estranho ter uma lacuna tão grande entre a RTX 5080 e a RTX 5090. Outras GPUs poderiam tentar preencher as lacunas, e eventualmente poderíamos ver partes de nível inferior que poderiam ter algo como 18.000 núcleos CUDA funcionais.
O que sabemos é que a Nvidia usa os mesmos chips para uma variedade de produtos: GPUs de desktop, móveis, profissionais e de data center são todos baseados nos mesmos designs de silício. Com a AI sendo um item tão quente agora, a Nvidia pode estar criando uma parte massiva de data center como a primeira prioridade, e então productizando-a como uma oferta de consumo também. Se for esse o caso, não se surpreenda se os preços acabarem sendo bem mais altos do que os já exorbitantes preços da RTX 4090 — e poderíamos até ver variantes de AI chegarem antes dos modelos de consumo.
Por enquanto, todas as informações que temos sobre as placas de vídeo baseadas em Blackwell para PCs cliente são estritamente não oficiais. Aplique o ceticismo usual e saiba que, até a Nvidia dizer algo diretamente, as coisas podem e provavelmente mudarão. Ainda há rumores conflitantes sobre a data de lançamento também, com alguns dizendo que a série RTX 50 não chegará até o início de 2025. Se correto, isso dá amplo tempo para ajustes contínuos antes do lançamento. Até o anúncio oficial, podemos esperar que a fábrica de rumores continue ocupada produzindo várias teorias e especificações.
Fonte: kopite7kimi